
Minimind:从零实现一个小型语言模型
个人实现地址:SanzeninMind 参考原型:MiniMind
目录
- 项目概览与模型配置
- 从文本到 Token:数据预处理
- 输入嵌入:Token ID → 向量
- RMSNorm:为什么不用 LayerNorm
- RoPE / YaRN:把位置信息转进 Query/Key
- GQA 注意力:省显存的多头机制
- FFN 与 MoE:从稠密到稀疏前馈
- 训练流程:预训练脚本详解
- 推理与评估:把模型跑起来
1. 项目概览与模型配置
SanzeninMind 是一个跟着 MiniMind 学习、从零实现的小型 Decoder-only 语言模型。当前代码已经覆盖了:
- Decoder-only 的 Transformer 骨架;
- 基于 HuggingFace
tokenizers的本地 BPE 词表; - 预训练数据流水线;
- RMSNorm、RoPE/YaRN、GQA Attention、SwiGLU FFN;
- MoE(Mixture-of-Experts)稀疏前馈;
- 预训练脚本与 Eval 推理脚本。
1.1 核心配置
模型配置集中在 model/model.py 的 SanzeninMindConfig:
class SanzeninMindConfig(PretrainedConfig): model_type = "sanzeninmind"
def __init__( self, hidden_size: int = 512, # 隐藏层维度 num_attention_heads: int = 8, # 注意力头数 num_key_value_heads: int = 2, # GQA 的 KV 头数 num_hidden_layers: int = 8, # Transformer 层数 vocab_size: int = 6400, # 词表大小 max_position_embeddings: int = 32768,# 最大序列长度 rope_theta: int = 1000000, # RoPE 基频 rms_norm_eps: float = 1e-05, use_moe: bool = True, num_experts_per_tok: int = 2, n_routed_experts: int = 4, n_shared_experts: int = 1, # ... )几个后文会反复用到的派生量:
head_dim = hidden_size // num_attention_headsrepeat_nums = num_attention_heads // num_key_value_heads(GQA 里每个 KV 头被多少个 Q 头共享)intermediate_size默认按hidden_size * 8 // 3向上取整到 64 的倍数。
以默认配置 hidden_size=512, num_attention_heads=8 为例:
| 超参 | 数值 |
|---|---|
head_dim |
64 |
num_key_value_heads |
2 |
repeat_nums |
4 |
intermediate_size |
1408 |
trainer/train_pretrain.py 默认把 hidden_size 覆盖成 768,此时 head_dim=96,intermediate_size=2048。
1.2 整体架构
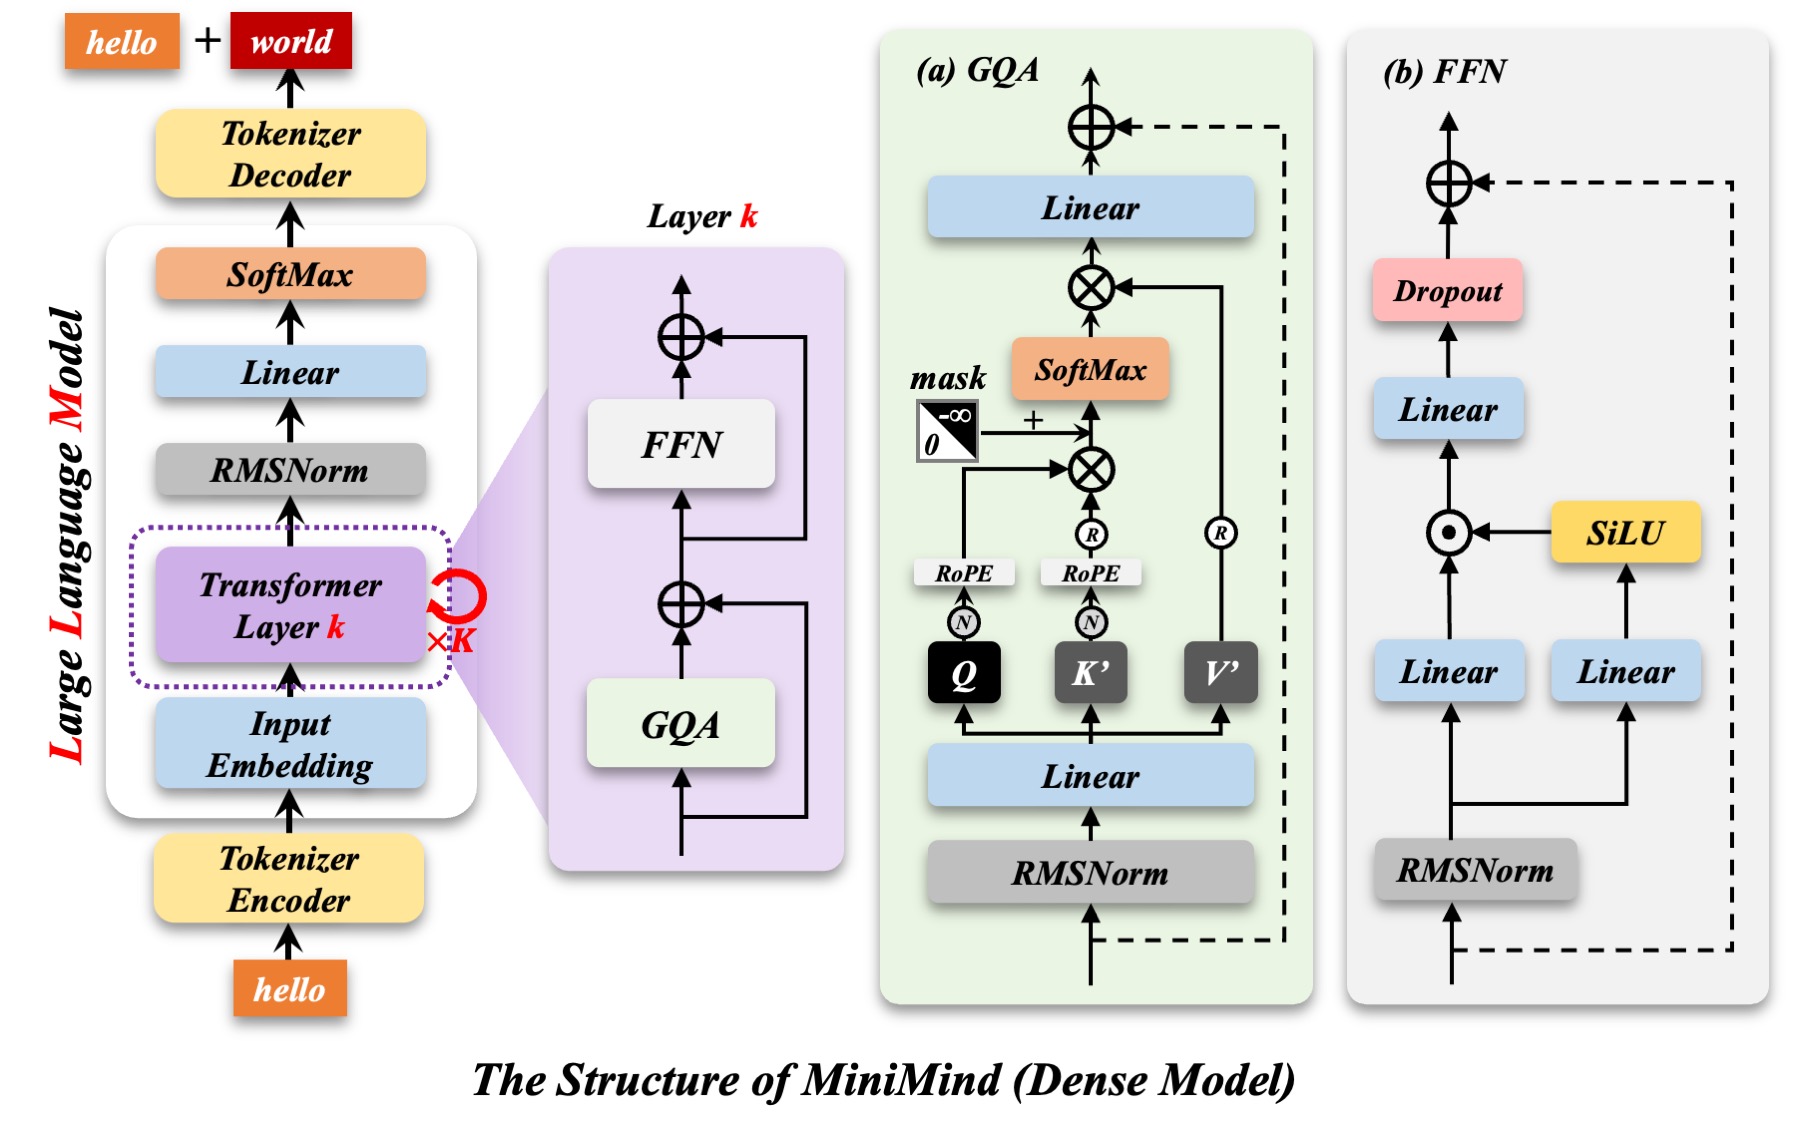
上图是 MiniMind 的 Dense 模型结构。数据流可以概括为:
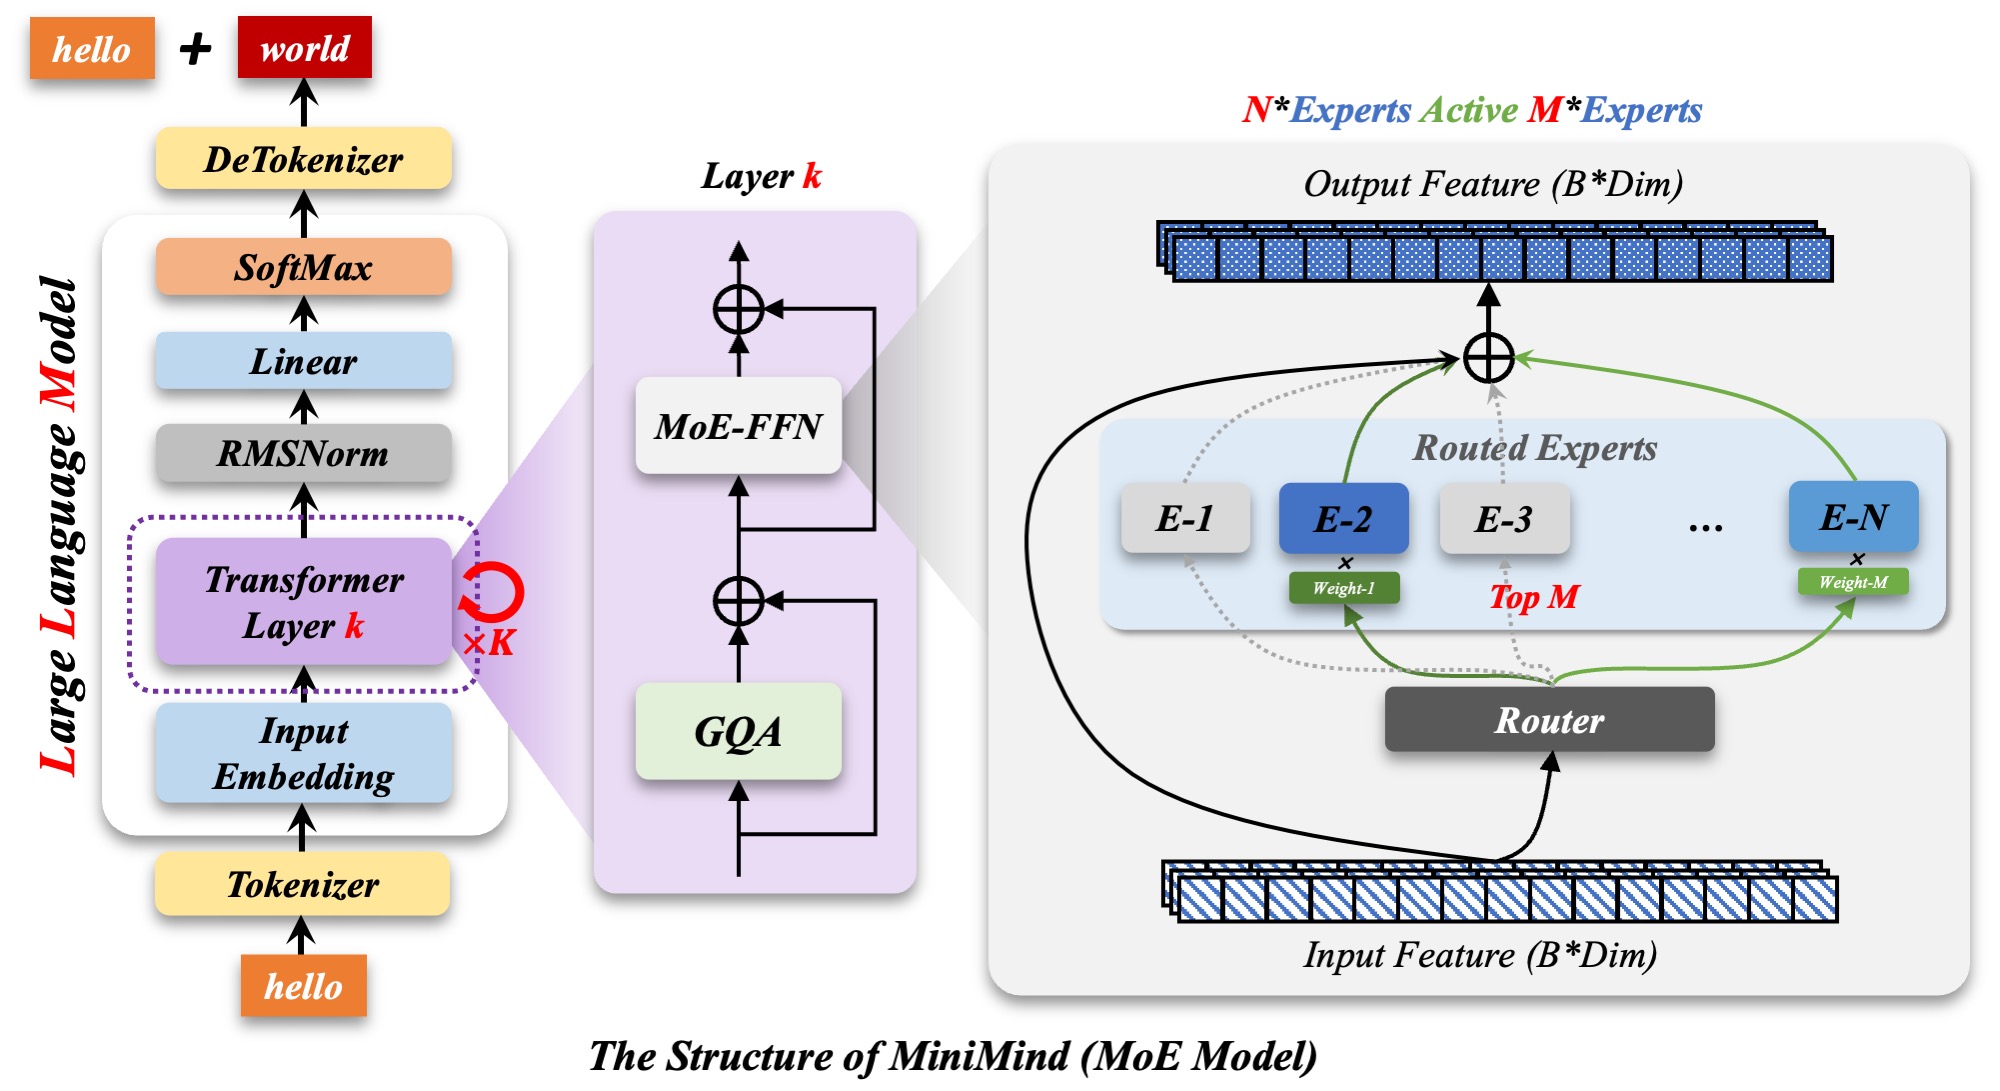
Tokenizer → Input Embedding → [RMSNorm → GQA + RoPE → 残差 → RMSNorm → FFN/MoE → 残差] × L → RMSNorm → LM Head → SoftmaxSanzeninMind 在 Dense 基础上增加了可选的 MoE-FFN:
2. 从文本到 Token:数据预处理
预训练数据放在 dataset/pretrain_t2t_mini.jsonl,每行一个 JSON:
{"text": "神经网络是一种模仿动物神经网络行为特征的算法模型..."}dataset/lm_dataset.py 里的 PretrainDataset 做三件事:惰性加载、tokenize、补齐并生成 labels。
class PretrainDataset(Dataset): def __init__(self, data_path, tokenizer: PreTrainedTokenizerBase, max_length=512): super().__init__() self.tokenizer = tokenizer self.max_length = max_length # HuggingFace datasets 惰性加载,避免一次性读入大文件 self.samples = load_dataset("json", data_files=data_path, split="train")
def __len__(self): return len(self.samples)
def __getitem__(self, index): sample = self.samples[index]
# tokenize,不自动加特殊 token,max_length 留出 2 个位置给 BOS 和 EOS tokens = self.tokenizer( str(sample["text"]), add_special_tokens=False, max_length=self.max_length - 2, truncation=True, ).input_ids
# 手动拼接 BOS + 正文 token + EOS tokens = [self.tokenizer.bos_token_id] + tokens + [self.tokenizer.eos_token_id]
# 右侧 PAD 补齐到 max_length pad_len = self.max_length - len(tokens) input_ids = tokens + [self.tokenizer.pad_token_id] * pad_len input_ids = torch.tensor(input_ids, dtype=torch.long)
# labels 与 input_ids 相同,PAD 位置置 -100 让 CrossEntropy 忽略 labels = input_ids.clone() labels[input_ids == self.tokenizer.pad_token_id] = -100
return input_ids, labels形状变化:
原始文本 : strinput_ids : [max_length] (torch.long)labels : [max_length] (PAD 位置为 -100)Tokenizer 配置(model/tokenizer_config.json):
bos_token:<|im_start|>(id=1)eos_token:<|im_end|>(id=2)pad_token:<|endoftext|>(id=0)
为什么 labels 和 input_ids 相同?
因果语言模型训练的是”给定前 t 个 token,预测第 t+1 个 token”。在 SanzeninMindForCausalLM.forward 里会手动错位:
shift_logits = logits[..., :-1, :].contiguous()shift_labels = labels[..., 1:].contiguous()所以 Dataset 里 labels 直接复用 input_ids 就行。
3. 输入嵌入:Token ID → 向量
模型入口在 SanzeninMindForCausalLM.forward:
batch_size, seq_len = input_ids.shapehidden_states = self.model.dropout(self.model.embed_tokens(input_ids))embed_tokens 就是一个 nn.Embedding(vocab_size, hidden_size)。
形状变化(以 hidden_size=512 为例):
input_ids : [batch_size, seq_len] 例如 [2, 128]embed_tokens : [vocab_size, hidden_size] [6400, 512]hidden_states : [batch_size, seq_len, hidden_size] [2, 128, 512]每个 token id 去词表里查一行,得到一个 hidden_size 维向量。这一步之后,模型还不知道 token 的顺序——之后的rope位置编码就是来解决这个问题的。
4. RMSNorm:为什么不用 LayerNorm
4.1 动机
LayerNorm 的公式是:
其中:
RMSNorm 的作者发现,在 Transformer 里减去均值这一步并不是必须的,直接用均方根做归一化就够了:
这样做有两个好处:
- 计算量减少:省掉一次求均值和方差中的减均值操作;
- 效果相当:在 LLaMA、Qwen 等主流模型中被验证有效。
4.2 代码实现
class RMSNorm(nn.Module): def __init__(self, dim: int, eps: float = 1e-8): super().__init__() self.eps = eps # 可学习的逐维度缩放参数 gamma,初始为 1 self.weight = nn.Parameter(torch.ones(dim))
def norm(self, x: torch.Tensor): return x * torch.rsqrt(x.pow(2).mean(-1, keepdim=True) + self.eps)
def forward(self, x: torch.Tensor): # 先转 float32 做归一化,避免低精度数值问题,再转回输入 dtype return (self.weight * self.norm(x.float())).type_as(x)关键点:
x.pow(2).mean(-1, keepdim=True)对最后一个维度hidden_size求平方均值,返回[batch_size, seq_len, 1];torch.rsqrt(...)等价于1 / sqrt(...),是 PyTorch 里更快也更稳定的写法;self.weight是可学习的逐维度缩放参数,形状[hidden_size];.type_as(x)把 float32 的归一化结果转回输入 dtype(如 bfloat16)。
形状变化:
输入 x : [batch_size, seq_len, hidden_size] [2, 128, 512]x.pow(2).mean(-1, keepdim=True) : [2, 128, 1]缩放系数 : [2, 128, 1]输出 : [batch_size, seq_len, hidden_size] [2, 128, 512]RMSNorm 不改变形状,只改变数值分布。它出现在三个地方:每个 Transformer Block 的 Attention 之前、FFN/MoE 之前、以及最后一层之后。
5. RoPE / YaRN:把位置信息转进 Query/Key
5.1 动机
Transformer 本身对输入顺序不敏感——Self-Attention 是置换等变的。早期做法是把绝对位置编码直接加到 Embedding 上:
但这样只能表达绝对位置。RoPE(Rotary Position Embedding)的思路是:对 Query 和 Key 的每两个维度做一次二维旋转,让注意力点积里天然出现 和 ,从而表达相对位置差。
5.2 二维旋转推导
取 query 和 key 的某两个维度,分别记为向量:
对位置 的 query 旋转角度 ,对位置 的 key 旋转角度 ,旋转矩阵为:
于是:
计算点积 ,展开并整理后:
关键结论:位置信息只与相对距离 有关,这正是 RoPE 名字的由来。
5.3 频率分配
RoPE 把 head_dim 维向量按二维一组处理,第 组的频率为:
- 越小, 越大 → 高频,对局部位置敏感;
- 越大, 越小 → 低频,负责长距离关系。
对应波长(转一圈需要的步数)为:
5.4 代码实现:precompute_freqs_cis
def precompute_freqs_cis(dim, rope_base, end=(32*1024), rope_scaling=None): # 生成每对维度的旋转基频 # torch.arange(0, dim, 2) 取 0, 2, 4, ..., 共 dim//2 个频率组 # 第 i 组频率 theta_i = 1 / rope_base^(2i / dim) freqs = 1.0 / (rope_base ** (torch.arange(0, dim, 2)[:dim//2].float() / dim)) attention_factor = 1.0
# 如果启用 YaRN / RoPE scaling,对低频做外推缩放 if rope_scaling is not None: orig_max = rope_scaling["original_max_position_embeddings"] factor = rope_scaling["factor"] beta_fast = rope_scaling["beta_fast"] beta_slow = rope_scaling["beta_slow"] attention_factor = rope_scaling.get("attention_factor", 1.0)
if end > orig_max: # inv_dim: 把"在训练长度内旋转 beta 圈"的条件映射回维度索引 i inv_dim = lambda b: (dim * math.log(orig_max / (b * 2 * math.pi))) / (2 * math.log(rope_base)) low = max(math.floor(inv_dim(beta_fast)), 0) high = min(math.ceil(inv_dim(beta_slow)), dim // 2 - 1)
# ramp: 在 [low, high] 区间内从 0 平滑过渡到 1 # i < low 时 ramp=0(高频,不缩放) # i > high 时 ramp=1(低频,除以 factor) # low <= i <= high 时线性插值(中频,平滑过渡) ramp = torch.clamp( (torch.arange(dim // 2, device=freqs.device).float() - low) / max(high - low, 0.001), 0, 1 ) freqs = freqs * (1 - ramp + ramp / factor)
# 生成位置索引,并计算每个位置、每个频率的旋转角度 t = torch.arange(end, device=freqs.device).float() freqs = torch.outer(t, freqs).float()
# 把角度表复制一份,拼成 [end, dim],分别对应前半维和后半维 freqs_cos = torch.cat([torch.cos(freqs), torch.cos(freqs)], dim=-1) * attention_factor freqs_sin = torch.cat([torch.sin(freqs), torch.sin(freqs)], dim=-1) * attention_factor return freqs_cos, freqs_sin形状变化:
torch.arange(0, dim, 2) : [dim//2] 例如 [32]freqs : [dim//2] [32]t : [end] [32768]torch.outer(t, freqs) : [end, dim//2] [32768, 32]torch.cat([cos, cos], dim=-1): [end, dim] [32768, 64]在 SanzeninMindForCausalLM.__init__ 中,dim 传入的是 head_dim(64 或 96),所以 freqs_cos 形状是 [max_position_embeddings, head_dim]。
5.5 YaRN:按频率分段的外推缩放
符号约定
| 符号 | 含义 |
|---|---|
| head_dim | |
| RoPE 频率组索引, | |
| 第 组维度的旋转频率 | |
| 第 组维度的波长 | |
训练时的最大长度,代码中叫 orig_max |
|
| 某个维度在训练长度 内旋转的圈数 | |
| 外推缩放因子 | |
| 之间的平滑过渡系数 |
波长与频率的关系
频率 表示 token 每前进一步,向量在复平面上旋转的弧度。转满一圈 需要的步数就是波长:
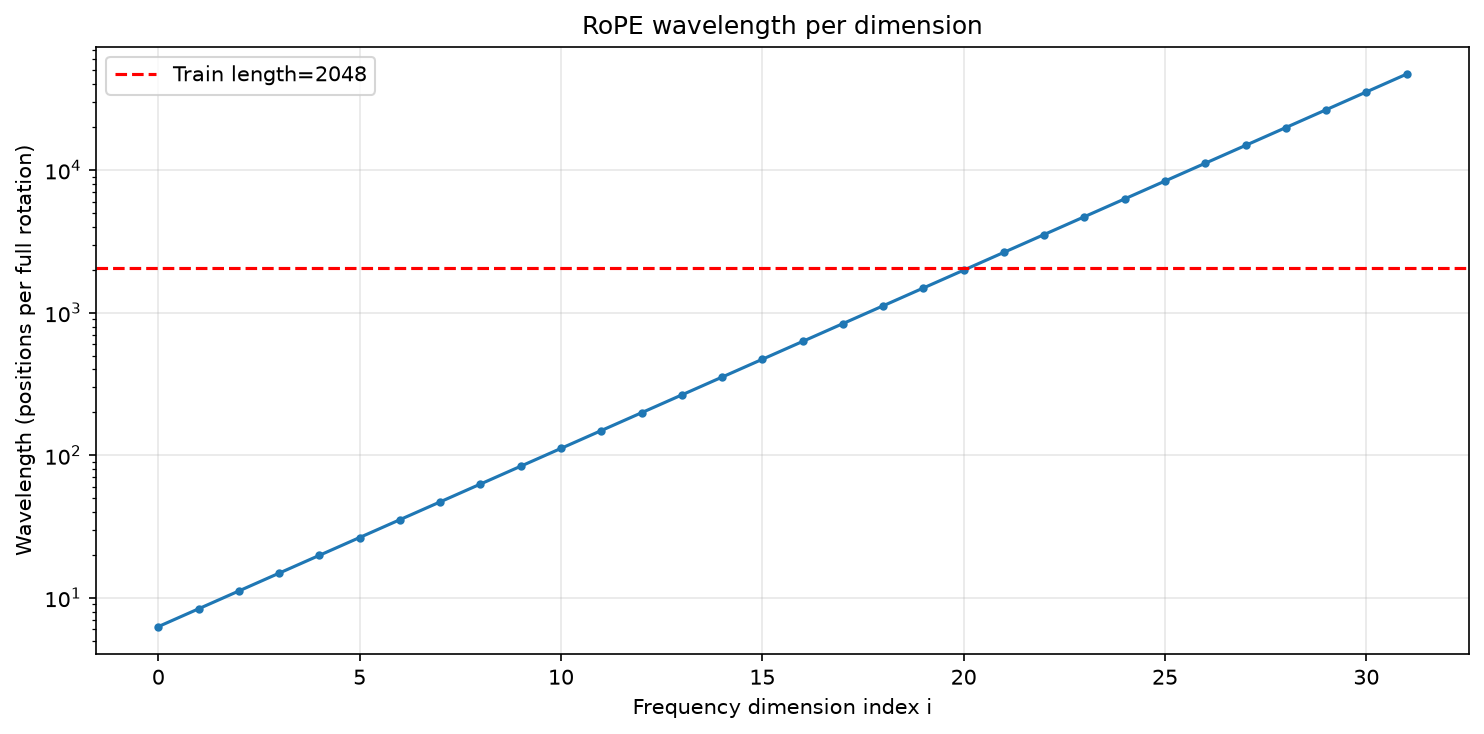
- 高频维度( 小):波长短,如 时波长仅约 6;
- 低频维度( 大):波长长,如 时波长超过 20000。
从”旋转圈数”到维度索引
YaRN 用 beta_fast 和 beta_slow 划分频段。它们的含义是:在原始训练长度 内,某个维度大约旋转 圈。
于是:
把 RoPE 频率公式代入,解出维度索引 :
代码里就是:
inv_dim = lambda b: (dim * math.log(orig_max / (b * 2 * math.pi))) / (2 * math.log(rope_base))对 beta_fast 和 beta_slow 分别调用 inv_dim,得到两个临界索引 low 和 high:
- :在训练长度内旋转圈数多于
beta_fast→ 高频; - :中频;
- :在训练长度内旋转圈数少于
beta_slow→ 低频。
YaRN 缩放公式
对频率做分段处理:
其中 ramp 是一个在 之间平滑过渡的向量:
ramp = torch.clamp( (torch.arange(dim // 2, device=freqs.device).float() - low) / max(high - low, 0.001), 0, 1)- 当 (高频):,,不缩放,保留局部精度;
- 当 (低频):,,显著放慢,让长距离位置落回训练分布;
- 当中间:,线性插值,平滑过渡。
为什么要这样分段?
如果不做任何外推缩放,三个频段在超长序列下的表现截然不同。
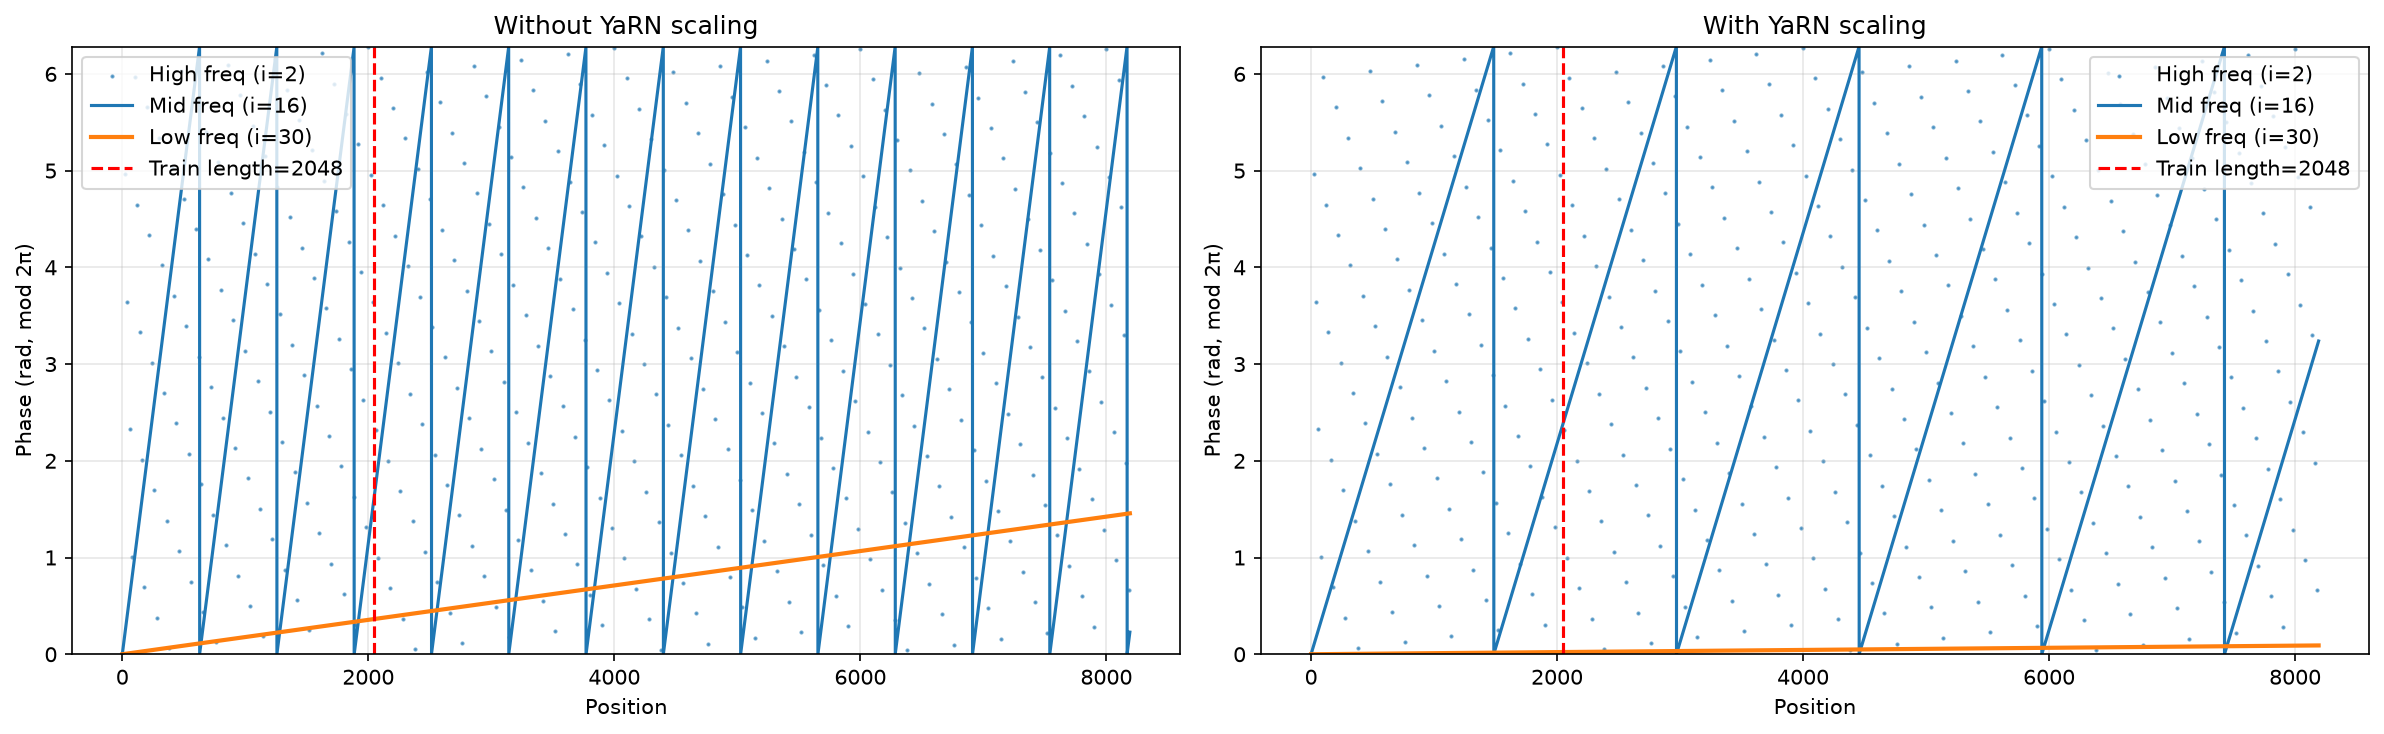
上图横轴是位置,纵轴是相位(对 取模),红线标出训练长度 。
左图:不缩放
- 高频(散点):继续快速周期震荡。训练时已经见过很多完整周期,外推时相位值仍是熟悉的;
- 中频(蓝色折线):超过训练长度后进入部分未见过相位,但波长较短,还能靠周期性维持;
- 低频(橙色折线):最致命。训练时只见过 左右一小段,外推后相位一路飙升到 以上,完全脱离训练分布。模型学到的长距离位置规律在这里失效。
右图:YaRN 缩放
- 高频:轨迹几乎不变,局部精度保留;
- 中频:被适度放慢,相位轨迹被”压回”训练区间;
- 低频:被显著放慢,原本到 8000 位置才涨到 ,现在几乎贴地,仍落在训练时见过的相位范围内。
YaRN 的核心直觉:不要一刀切地把所有频率都放慢,只放慢训练时没见过长距离相位的低频维度,同时保护高频的局部精度。
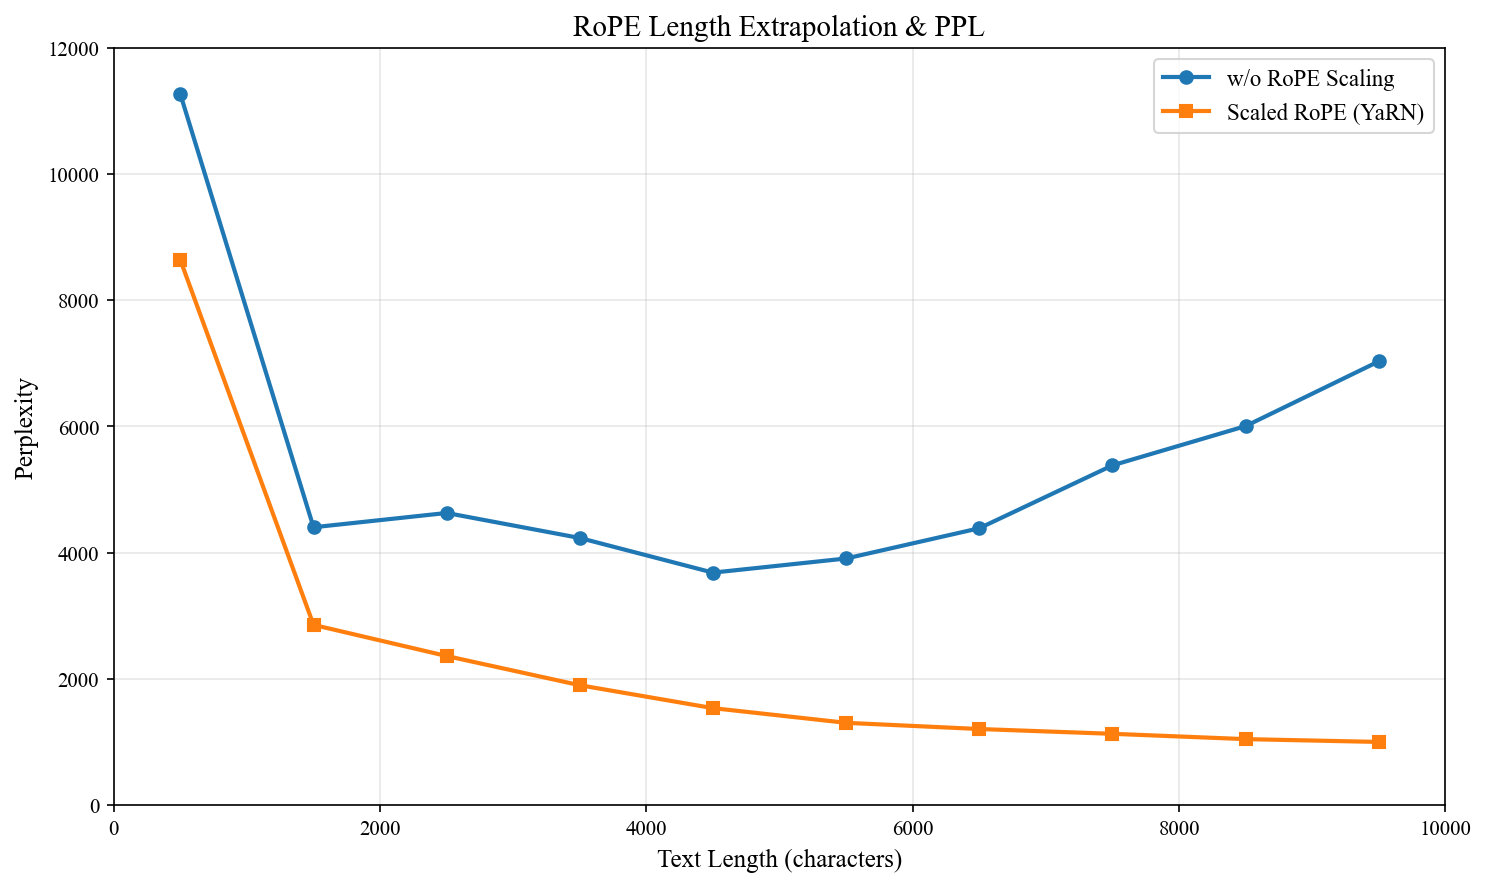
下图是 MiniMind 官方给出的 RoPE 外推效果:开启 YaRN 后,长文本困惑度明显更低。
5.6 应用旋转:apply_rotary_pos_emb
def apply_rotary_pos_emb(q, k, cos, sin, position_ids=None, unsqueeze_dim=1): def rotate_half(x): # 把向量按前后两半拆分: # 输入 x = [x_1, ..., x_{d/2}, x_{d/2+1}, ..., x_d] # 输出 = [-x_{d/2+1}, ..., -x_d, x_1, ..., x_{d/2}] return torch.cat([ -x[..., x.shape[-1]//2:], x[..., :x.shape[-1]//2] ], dim=-1)
q_embed = q * cos.unsqueeze(unsqueeze_dim) + rotate_half(q) * sin.unsqueeze(unsqueeze_dim) k_embed = k * cos.unsqueeze(unsqueeze_dim) + rotate_half(k) * sin.unsqueeze(unsqueeze_dim) return q_embed, k_embed这里的配对方式是”前半维与后半维配对”:把向量分成前 维和后 维,对应位置组成二维旋转对。
设 ,则:
于是:
这与二维旋转公式完全等价,只是索引约定不同。
形状变化(Attention 内部):
进入 Attention 前: xq : [batch_size, seq_len, num_heads * head_dim] [2, 128, 512] xk : [batch_size, seq_len, num_kv_heads * head_dim] [2, 128, 128] xv : [batch_size, seq_len, num_kv_heads * head_dim] [2, 128, 128]
view 拆头后: xq : [batch_size, seq_len, num_heads, head_dim] [2, 128, 8, 64] xk : [batch_size, seq_len, num_kv_heads, head_dim] [2, 128, 2, 64] xv : [batch_size, seq_len, num_kv_heads, head_dim] [2, 128, 2, 64]
RoPE 前 cos/sin (从 buffer 中切片): cos : [seq_len, head_dim] [128, 64]
unsqueeze(1) 后: cos : [seq_len, 1, head_dim] [128, 1, 64]
应用 RoPE 后: q_embed : [batch_size, seq_len, num_heads, head_dim] [2, 128, 8, 64] k_embed : [batch_size, seq_len, num_kv_heads, head_dim] [2, 128, 2, 64]6. GQA 注意力:省显存的多头机制
6.1 动机
标准 Multi-Head Attention(MHA)中,每个注意力头都有独立的 Q/K/V 投影。当模型很大、序列很长时,KV Cache 会占用大量显存。
GQA(Grouped-Query Attention)让多个 Query 头共享同一组 K/V 头:
num_attention_heads个 Q 头;num_key_value_heads个 K/V 头;- 每个 K/V 头被
repeat_nums = num_attention_heads // num_key_value_heads个 Q 头共享。
这样 KV Cache 大小降到原来的 num_key_value_heads / num_attention_heads。
6.2 代码实现
class Attention(nn.Module): def __init__(self, args: SanzeninMindConfig): super().__init__() self.num_key_value_heads = args.num_key_value_heads assert args.num_attention_heads % self.num_key_value_heads == 0, \ "num_attention_heads 必须能被 num_key_value_heads 整除"
self.local_heads = args.num_attention_heads self.local_kv_heads = self.num_key_value_heads self.repeat_nums = self.local_heads // self.local_kv_heads self.head_dim = args.hidden_size // args.num_attention_heads
# Q/K/V/O 投影,均无偏置 self.q_proj = nn.Linear(args.hidden_size, self.head_dim * self.local_heads, bias=False) self.k_proj = nn.Linear(args.hidden_size, self.head_dim * self.local_kv_heads, bias=False) self.v_proj = nn.Linear(args.hidden_size, self.head_dim * self.local_kv_heads, bias=False) self.o_proj = nn.Linear(self.head_dim * self.local_heads, args.hidden_size, bias=False)
self.attn_dropout = nn.Dropout(args.dropout) self.resid_dropout = nn.Dropout(args.dropout) self.dropout = args.dropout
# 检测 PyTorch 是否支持 Flash Attention fused kernel self.flash = hasattr(nn.functional, 'scaled_dot_product_attention') and args.flash_attention
def forward( self, x: torch.Tensor, position_embeddings: Tuple[torch.Tensor, torch.Tensor], past_key_value: Optional[Tuple[torch.Tensor, torch.Tensor]] = None, use_cache: bool = False, attention_mask: Optional[torch.Tensor] = None, ) -> Tuple[torch.Tensor, Optional[KVCache]]: batch_size, seq_len, _ = x.shape
# 线性投影得到 Q/K/V # xq: [B, S, num_heads * head_dim] # xk/xv: [B, S, num_kv_heads * head_dim] xq, xk, xv = self.q_proj(x), self.k_proj(x), self.v_proj(x)
# reshape 成多头形式 xq = xq.view(batch_size, seq_len, self.local_heads, self.head_dim) xk = xk.view(batch_size, seq_len, self.local_kv_heads, self.head_dim) xv = xv.view(batch_size, seq_len, self.local_kv_heads, self.head_dim)
# 应用 RoPE 位置编码(只对 Q/K,V 不需要) cos, sin = position_embeddings xq, xk = apply_rotary_pos_emb(xq, xk, cos, sin)
# KV Cache 拼接(推理时复用已计算的 key/value) if past_key_value is not None: xk = torch.cat([past_key_value[0], xk], dim=1) xv = torch.cat([past_key_value[1], xv], dim=1) past_kv = (xk, xv) if use_cache else None
# 调整维度并复制 KV 头以匹配 Q 头数量 # 从 [B, S, H, D] -> [B, H, S, D],便于做 batch 矩阵乘法 xq, xk, xv = ( xq.transpose(1, 2), repeat_kv(xk, self.repeat_nums).transpose(1, 2), repeat_kv(xv, self.repeat_nums).transpose(1, 2), )
# 注意力计算 if ( self.flash and seq_len > 1 and past_key_value is None and (attention_mask is None or torch.all(attention_mask == 1)) ): # Flash Attention 快速路径:fused kernel,省显存 output = F.scaled_dot_product_attention( xq, xk, xv, dropout_p=self.dropout if self.training else 0.0, is_causal=True, ) else: # 手动实现路径 # scores[b, h, q_pos, k_pos] 表示第 h 头中 q_pos 对 k_pos 的注意力分数 scores = (xq @ xk.transpose(-2, -1)) / math.sqrt(self.head_dim)
# Causal Mask:当前 query 位置只能看到当前及之前的 key 位置 # scores 最后一维是 cached_seq_len + seq_len,只对最右侧 seq_len 加掩码 scores[:, :, :, -seq_len:] += torch.triu( torch.full((seq_len, seq_len), float('-inf'), device=scores.device), diagonal=1 )
# Padding Mask:把 PAD 位置对应的分数置为 -inf if attention_mask is not None: extended_attention_mask = attention_mask.unsqueeze(1).unsqueeze(2) extended_attention_mask = (1 - extended_attention_mask) * (-1e9) scores = scores + extended_attention_mask
scores = F.softmax(scores.float(), dim=-1).type_as(xq) scores = self.attn_dropout(scores) output = scores @ xv
# 合并多头并做输出投影 output = output.transpose(1, 2).reshape(batch_size, seq_len, -1) output = self.resid_dropout(self.o_proj(output)) return output, past_kv6.3 repeat_kv:把 KV 头复制给多个 Q 头
def repeat_kv(x: torch.Tensor, repeat_nums: int) -> torch.Tensor: bs, seq_len, num_key_value_heads, head_dim = x.shape if repeat_nums == 1: return x
return ( x[:, :, :, None, :] .expand(bs, seq_len, num_key_value_heads, repeat_nums, head_dim) .reshape(bs, seq_len, num_key_value_heads * repeat_nums, head_dim) )形状变化:
输入 x : [2, 128, 2, 64]x[:, :, :, None, :] : [2, 128, 2, 1, 64]expand(..., repeat_nums) : [2, 128, 2, 4, 64]reshape(..., 2*4, 64) : [2, 128, 8, 64]6.4 Attention 完整形状流
x (经 RMSNorm 后) : [2, 128, 512]
投影: q_proj: [512, 512] -> xq [2, 128, 512] k_proj: [512, 128] -> xk [2, 128, 128] v_proj: [512, 128] -> xv [2, 128, 128]
拆头: xq [2, 128, 8, 64] xk [2, 128, 2, 64] xv [2, 128, 2, 64]
RoPE 后形状不变
KV Cache 拼接后 (假设已有 64 个缓存位置): xk [2, 192, 2, 64] xv [2, 192, 2, 64]
transpose + repeat_kv: xq [2, 8, 128, 64] xk [2, 8, 192, 64] xv [2, 8, 192, 64]
注意力得分: scores = xq @ xk.T -> [2, 8, 128, 192] softmax 后 -> [2, 8, 128, 192] output = scores @ xv -> [2, 8, 128, 64]
合并头: transpose -> [2, 128, 8, 64] reshape -> [2, 128, 512]
o_proj: [512, 512] -> output [2, 128, 512]6.5 Causal Mask
手动实现分支里:
scores[:, :, :, -seq_len:] += torch.triu( torch.full((seq_len, seq_len), float('-inf'), device=scores.device), diagonal=1)scores 的最后一维是 cached_seq_len + seq_len。我们只对最右边的 seq_len 个位置加上三角 mask,保证当前 token 看不到未来 token。
6.6 Flash Attention 快速路径
F.scaled_dot_product_attention 是 PyTorch 2.0+ 提供的 fused attention 封装,传入 is_causal=True 会自动构造因果 mask,并调用底层优化 kernel(FlashAttention / Memory-Efficient Attention / cuDNN),显著节省显存和计算。代码里只在 seq_len > 1、没有 KV Cache、没有 padding mask 时走这条路径,否则回退到手动实现。
7. FFN 与 MoE:从稠密到稀疏前馈
7.1 稠密 FFN:SwiGLU
class FeedForward(nn.Module): # 增加 intermediate_size 参数,方便 MoE 每个专家传入 config.moe_intermediate_size def __init__(self, config: SanzeninMindConfig, intermediate_size: int = None): super().__init__() # 优先使用调用方传入的 intermediate_size;否则使用 config.intermediate_size;都没有时再自动计算 intermediate_size = intermediate_size if intermediate_size is not None else config.intermediate_size if intermediate_size is None: intermediate_size = config.hidden_size * 8 // 3 intermediate_size = 64 * ((intermediate_size + 63) // 64) # 向上取整为 64 的倍数,有利于 GPU 性能
self.gate_proj = nn.Linear(config.hidden_size, intermediate_size, bias=False) self.down_proj = nn.Linear(intermediate_size, config.hidden_size, bias=False) self.up_proj = nn.Linear(config.hidden_size, intermediate_size, bias=False) self.dropout = nn.Dropout(config.dropout) # 通常是 silu,即 Swish 激活 self.act_fn = ACT2FN[config.hidden_act]
def forward(self, x): # SwiGLU: silu(gate_proj(x)) * up_proj(x) 逐元素相乘,再过 down_proj return self.dropout(self.down_proj(self.act_fn(self.gate_proj(x)) * self.up_proj(x)))形状变化(hidden_size=512, intermediate_size=1408):
x : [2, 128, 512]gate_proj(x) : [2, 128, 1408]up_proj(x) : [2, 128, 1408]act_fn(gate) * up : [2, 128, 1408]down_proj(...) : [2, 128, 512]SwiGLU 用两个投影(gate 和 up)逐元素相乘后再投影回去,表达能力比单投影 + ReLU/GELU 更强,这也是 LLaMA2/3、Qwen 等模型的选择。
7.2 MoE:稀疏激活的专家层
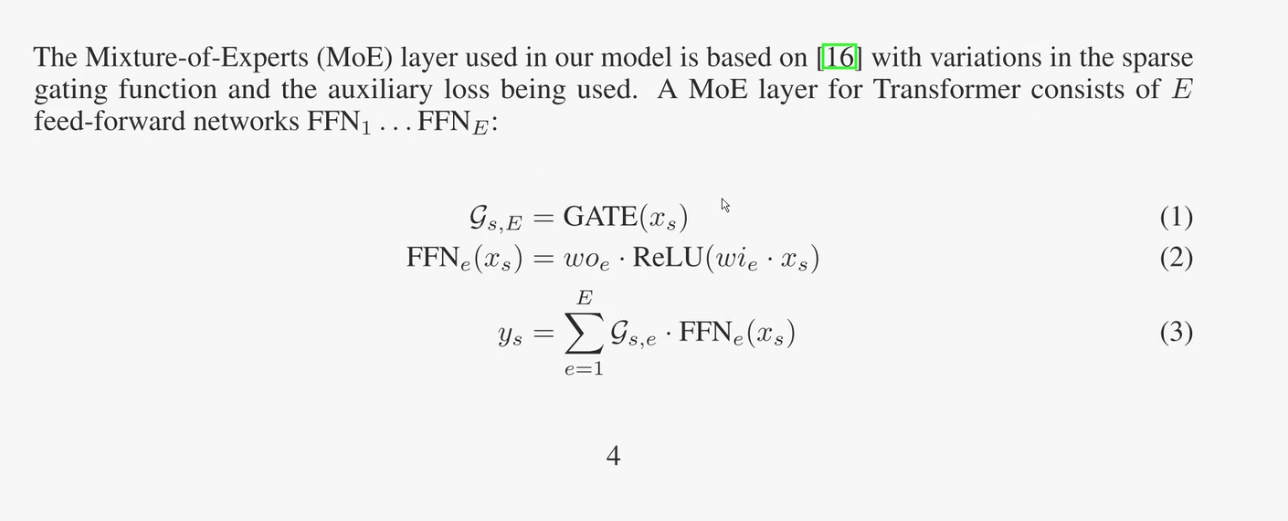
MoE(Mixture-of-Experts)把一个大 FFN 拆成多个小 FFN(专家),并用一个 Router 决定每个 token 激活哪几个专家。
形式上,对于输入 ,Router 输出门控分数:
每个专家 独立计算,最终输出是门控分数与专家输出的加权和:
class MoEGate(nn.Module): def __init__(self, config): super().__init__() self.config = config # Router:把每个 token 的 hidden 向量映射到专家数维度的分数 self.gate = nn.Linear(config.hidden_size, config.num_experts, bias=False)
# 被 Router 选中的专家(稀疏激活) self.experts = nn.ModuleList([ FeedForward(config, intermediate_size=config.moe_intermediate_size) for _ in range(config.num_experts) ])
# 共享专家:所有 token 都会经过,提供公共知识通道 self.shared_experts = nn.ModuleList([ FeedForward(config, intermediate_size=config.moe_intermediate_size) for _ in range(config.n_shared_experts) ]) # 共享专家同样使用 silu 激活 self.act_fn = ACT2FN[config.hidden_act] self.aux_loss = torch.tensor(0.0)
def forward(self, x: torch.Tensor): batch_size, seq_len, hidden_dim = x.shape identity = x # 保存原始输入,用于共享专家残差
# 把所有 token 展平成二维,方便统一做路由 x_flat = x.view(-1, hidden_dim)
# Router 输出每个 token 对每个专家的分数,并 softmax 归一化 scores = F.softmax(self.gate(x_flat), dim=-1)
# 每个 token 选出 Top-K 个专家 # topk_weight: [token_count, num_experts_per_tok] 选中专家的权重 # topk_idx: [token_count, num_experts_per_tok] 选中专家的编号 topk_weight, topk_idx = torch.topk( scores, k=self.config.num_experts_per_tok, dim=-1, sorted=False )
# 可选:对 Top-K 权重做归一化,使每个 token 的专家权重和为 1 if self.config.norm_topk_prob: topk_weight = topk_weight / (topk_weight.sum(dim=-1, keepdim=True) + 1e-20)
# 准备输出缓存,遍历每个专家,只处理被路由到的 token y = torch.zeros_like(x_flat) for i, expert in enumerate(self.experts): # mask[b, k] 表示第 b 个 token 的第 k 个 topk 是否选中了专家 i mask = (topk_idx == i)
if mask.any(): # 找出选中专家 i 的所有 token 的索引 token_idx = mask.any(dim=-1).nonzero().flatten() # 取出这些 token 对应专家 i 的权重,reshape 以便广播 weight = topk_weight[mask].view(-1, 1) # 只对选中的 token 过专家 FFN,并乘以对应权重 expert_out = expert(x_flat[token_idx]) * weight # 把专家输出累加回全局输出 y 的对应位置 y.index_add_(0, token_idx, expert_out.to(y.dtype)) elif self.training: # 训练时,即使某个专家没被选中,也要让它参与计算图, # 否则参数会长期不更新。0 * sum(parameters) 是无实际数值影响但有梯度的操作 y[0, 0] += 0 * sum(p.sum() for p in expert.parameters())
y = y.view(batch_size, seq_len, hidden_dim)
# 加上共享专家的输出(所有 token 都经过) for expert in self.shared_experts: shared_out = expert(identity) y = y + shared_out
# 计算辅助损失,防止路由崩塌(某些专家始终不被选中) if self.training and self.config.router_aux_loss_coef > 0: # load[k, e]: 专家 e 作为第 k 个 topk 被选中的平均频率 load = F.one_hot(topk_idx, self.config.num_experts).float().mean(0) self.aux_loss = ( (load * scores.mean(0)).sum() * self.config.num_experts * self.config.router_aux_loss_coef ) else: self.aux_loss = scores.new_zeros(1).squeeze()
return y形状变化(num_experts=4, num_experts_per_tok=2):
x : [2, 128, 512]x_flat : [256, 512]
Router: gate(x_flat) : [256, 4] scores : [256, 4] topk_weight : [256, 2] topk_idx : [256, 2]
Experts (稀疏激活): 每个专家只处理被路由到的 token y : [256, 512] view 后 : [2, 128, 512]
Shared Experts: identity : [2, 128, 512] shared_out : [2, 128, 512] y = y + shared_out : [2, 128, 512]7.3 为什么要加 Shared Experts?
Shared Experts 是所有 token 都会经过的 FFN,相当于保留了 Dense FFN 的”公共知识通道”。这样做有两个好处:
- 稳定训练:避免所有知识都靠 Router 动态分配,降低路由随机性带来的抖动;
- 表达兜底:保证每个 token 都能获得一些基础变换,不因为路由选择而丢失信息。
7.4 辅助损失:防止路由崩塌
如果没有约束,Router 可能会把所有 token 都推给少数几个”受欢迎”的专家,其他专家学不到东西,这就是 路由崩塌(Router Collapse)。
辅助损失的设计思路是:让每个专家被均匀使用。代码中:
load = F.one_hot(topk_idx, num_experts).float().mean(0) # [K, E]self.aux_loss = (load * scores.mean(0)).sum() * num_experts * router_aux_loss_coef它同时考虑了实际选中的频率(load)和路由分数的均值(scores.mean(0)),让两者都趋向均匀。
8. 训练流程:预训练脚本详解
8.1 主循环
trainer/train_pretrain.py 是预训练入口。核心训练循环:
def train_epoch(epoch, loader, iters, start_step=0, wandb=None): # 记录当前 epoch 的起始时间,用于估算剩余训练时间 start_time = time.time() # last_step 用于处理 epoch 末尾不足 accumulation_steps 的残余梯度 last_step = start_step
# loader 每次返回一个 batch;start_step 用于断点续训时从中间 step 继续计数 for step, (input_ids, labels) in enumerate(loader, start=start_step + 1): # 将输入和标签移动到训练设备,例如 cuda:0 或 cpu input_ids = input_ids.to(args.device) labels = labels.to(args.device) last_step = step
# 按当前训练进度计算学习率,实现随 step 变化的学习率调度 lr = get_lr(epoch * iters + step, args.epochs * iters, args.learning_rate) for param_group in optimizer.param_groups: param_group['lr'] = lr
# 在混合精度上下文中做前向计算,GPU 上可减少显存并加速 with autocast_ctx: # 传入 labels 后,模型内部会计算 next-token prediction 的交叉熵 loss res = model(input_ids, labels=labels) # 总 loss = 语言模型主损失 + MoE 路由辅助损失 loss = res.loss + res.aux_loss # 梯度累积时,每个小 batch 的 loss 要除以累积步数,保持总梯度尺度不变 loss = loss / args.accumulation_steps
# GradScaler 在 float16 训练时放大 loss,避免梯度下溢 scaler.scale(loss).backward()
# 每 accumulation_steps 个小 batch 才真正更新一次参数 if step % args.accumulation_steps == 0: # 梯度裁剪前先把 scaler 放大的梯度还原 scaler.unscale_(optimizer) # 裁剪梯度范数,防止梯度爆炸 torch.nn.utils.clip_grad_norm_(model.parameters(), args.grad_clip)
# optimizer.step() 的混合精度版本;若检测到 inf/NaN 梯度会跳过更新 scaler.step(optimizer) # 动态调整 loss scale,供下一轮 backward 使用 scaler.update()
# 清空梯度,set_to_none=True 可略省显存 optimizer.zero_grad(set_to_none=True)
# 定期打印训练日志,最后一个 step 也强制打印一次 if step % args.log_interval == 0 or step == iters: spend_time = time.time() - start_time # loss 前面除过 accumulation_steps,日志展示时乘回来 current_loss = loss.item() * args.accumulation_steps current_aux_loss = res.aux_loss.item() if res.aux_loss is not None else 0.0 current_logits_loss = current_loss - current_aux_loss current_lr = optimizer.param_groups[-1]['lr'] # 根据当前平均耗时粗略估算剩余分钟数 eta_min = spend_time / max(step - start_step, 1) * (iters - step) // 60 Logger(f'Epoch:[{epoch + 1}/{args.epochs}]({step}/{iters}), loss: {current_loss:.4f}, logits_loss: {current_logits_loss:.4f}, aux_loss: {current_aux_loss:.4f}, lr: {current_lr:.8f}, epoch_time: {eta_min:.1f}min') if wandb: wandb.log({"loss": current_loss, "logits_loss": current_logits_loss, "aux_loss": current_aux_loss, "learning_rate": current_lr, "epoch_time": eta_min})
# 定期保存权重和可恢复训练状态;只让主进程保存,避免多卡同时写文件 if (step % args.save_interval == 0 or step == iters) and is_main_process(): model.eval() moe_suffix = '_moe' if lm_config.use_moe else '' ckp = f'{args.save_dir}/{args.save_weight}_{lm_config.hidden_size}{moe_suffix}.pth' # DDP 包装后真实模型在 model.module;torch.compile 后可能在 _orig_mod raw_model = model.module if isinstance(model, DistributedDataParallel) else model raw_model = getattr(raw_model, '_orig_mod', raw_model) state_dict = raw_model.state_dict()
# 保存半精度权重用于推理/后续加载,减少磁盘占用 torch.save({k: v.half().cpu() for k, v in state_dict.items()}, ckp) # 额外保存 optimizer/scaler/epoch/step,支持断点续训 lm_checkpoint(lm_config, weight=args.save_weight, model=model, optimizer=optimizer, scaler=scaler, epoch=epoch, step=step, wandb=wandb, save_dir='../checkpoints') model.train() del state_dict
# 及时释放本轮 batch 的大对象引用,降低显存峰值 del input_ids, labels, res, loss
# 如果 epoch 结束时还攒着不足 accumulation_steps 的梯度,也执行一次参数更新 if last_step > start_step and last_step % args.accumulation_steps != 0: scaler.unscale_(optimizer) torch.nn.utils.clip_grad_norm_(model.parameters(), args.grad_clip) scaler.step(optimizer) scaler.update() optimizer.zero_grad(set_to_none=True)8.2 关键训练技巧
| 技巧 | 作用 | 代码体现 |
|---|---|---|
| 混合精度 | 加速训练、省显存 | torch.cuda.amp.autocast + GradScaler |
| 梯度累积 | 模拟大 batch | loss / accumulation_steps |
| 梯度裁剪 | 防止梯度爆炸 | clip_grad_norm_(..., grad_clip=1.0) |
| 余弦学习率 | 训练前期高、后期低 | get_lr(...) |
| 断点续训 | 从上次 step 恢复 | lm_checkpoint + SkipBatchSampler |
| DDP | 多卡并行 | DistributedDataParallel |
8.3 学习率调度
def get_lr(current_step, total_steps, lr): return lr * (0.1 + 0.45 * (1 + math.cos(math.pi * current_step / total_steps)))这是一个带 warm-up 底座的余弦退火:
- 初始学习率约为
lr(current_step=0时,cos(0)=1,括号内0.1 + 0.45*2 = 1.0); - 结束时约为
0.1 * lr(cos(π) = -1,括号内0.1 + 0)。
8.4 保存与恢复
trainer/trainer_utils.py 中的 lm_checkpoint 同时保存:
xxx.pth:半精度模型权重;xxx_resume.pth:模型 + 优化器 + scaler + epoch/step + wandb_id。
这样可以通过 --from_resume 1 从中断处继续训练。
9. 推理与评估:把模型跑起来
eval.py 是推理脚本。它支持两种加载方式:
--load_from model:加载本项目的原生 PyTorch 权重;- 其他路径:按 HuggingFace transformers 格式加载。
def print_model_params(model): # 统计所有可训练参数,方便确认当前加载的是哪个规模的模型 total_params = sum(p.numel() for p in model.parameters() if p.requires_grad) print(f"Model trainable params: {total_params / 1e6:.3f}M")
def init_model(args): # tokenizer 负责文本 <-> token id 的转换;默认从本地 model/ 目录加载 tokenizer = AutoTokenizer.from_pretrained(args.load_from)
# 官方逻辑:load_from 包含 "model" 时,认为加载的是本项目的原生 PyTorch 模型 if "model" in args.load_from: # 先按命令行参数创建同结构模型;权重 shape 必须和这些参数一致 model = SanzeninMindForCausalLM( SanzeninMindConfig( hidden_size=args.hidden_size, num_hidden_layers=args.num_hidden_layers, use_moe=bool(args.use_moe), inference_rope_scaling=args.inference_rope_scaling, ) )
# MoE 权重保存时通常会带 _moe 后缀,用来和 dense 模型区分 moe_suffix = "_moe" if args.use_moe else "" ckp = f"./{args.save_dir}/{args.weight}_{args.hidden_size}{moe_suffix}.pth"
# strict=True 要求权重文件和当前模型结构完全匹配,适合学习时尽早暴露不一致问题 model.load_state_dict(torch.load(ckp, map_location=args.device), strict=True) else: # 如果 load_from 不是本地 model/,就按 Hugging Face transformers 格式加载 model = AutoModelForCausalLM.from_pretrained( args.load_from, trust_remote_code=True, )
print_model_params(model)
# 推理阶段切到 eval 模式,关闭 dropout 等训练行为 model = model.eval().to(args.device) # GPU 推理时转半精度节省显存;CPU 上保持 float32 更稳 if "cuda" in args.device: model = model.half() return model, tokenizer
def build_inputs(args, tokenizer, conversation, prompt): # 预训练权重没有学聊天模板,直接用 BOS + 用户文本做续写 if "pretrain" in args.weight: return tokenizer.bos_token + prompt
# SFT/Chat 权重通常需要 chat template,把多轮对话渲染成模型训练时见过的格式 return tokenizer.apply_chat_template( conversation, tokenize=False, add_generation_prompt=True, open_thinking=bool(args.open_thinking), )9.1 推理时的关键参数
| 参数 | 说明 |
|---|---|
--inference_rope_scaling |
启用 YaRN 长上下文外推 |
--max_new_tokens |
最多生成多少个新 token |
--temperature |
采样温度,越高越随机 |
--top_p |
Nucleus Sampling 阈值 |
--historys |
保留多少轮对话历史 |
9.2 长文本外推
只要在创建配置时开启 inference_rope_scaling=True,就会启用 YaRN:
self.rope_scaling = { "beta_fast": 32, "beta_slow": 1, "factor": 16, "original_max_position_embeddings": 2048, "attention_factor": 1.0, "type": "yarn",}这意味着:模型虽然只在 2048 长度上训练,但推理时可以外推到 2048 * 16 = 32768 个位置。
向量形状全景图
以 batch_size=2, seq_len=128, hidden_size=512, num_heads=8, num_kv_heads=2, head_dim=64 为例:
input_ids [2, 128] ↓ embed_tokenshidden_states [2, 128, 512] ↓ [×8 Transformer Block] RMSNorm [2, 128, 512] → [2, 128, 512] Attention q_proj [2, 128, 512] k_proj [2, 128, 128] v_proj [2, 128, 128] view q[2,128,8,64], k[2,128,2,64], v[2,128,2,64] RoPE 形状不变 repeat_kv + transpose q[2,8,128,64], k[2,8,192,64], v[2,8,192,64] softmax @ v output [2,8,128,64] reshape + o_proj [2, 128, 512] 残差连接 [2, 128, 512] RMSNorm [2, 128, 512] FFN/MoE [2, 128, 512] 残差连接 [2, 128, 512] ↓ final RMSNormhidden_states [2, 128, 512] ↓ lm_headlogits [2, 128, 6400] ↓ cross_entropyloss scalar分享文章
生成精美分享图或复制链接,与更多人分享本文。
继续阅读
换条路线
从其他文章中稳定抽取
最后更新于 ,距今已过 98 天
部分内容可能已过时