
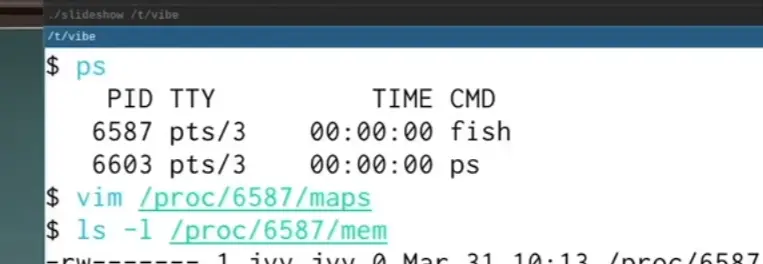
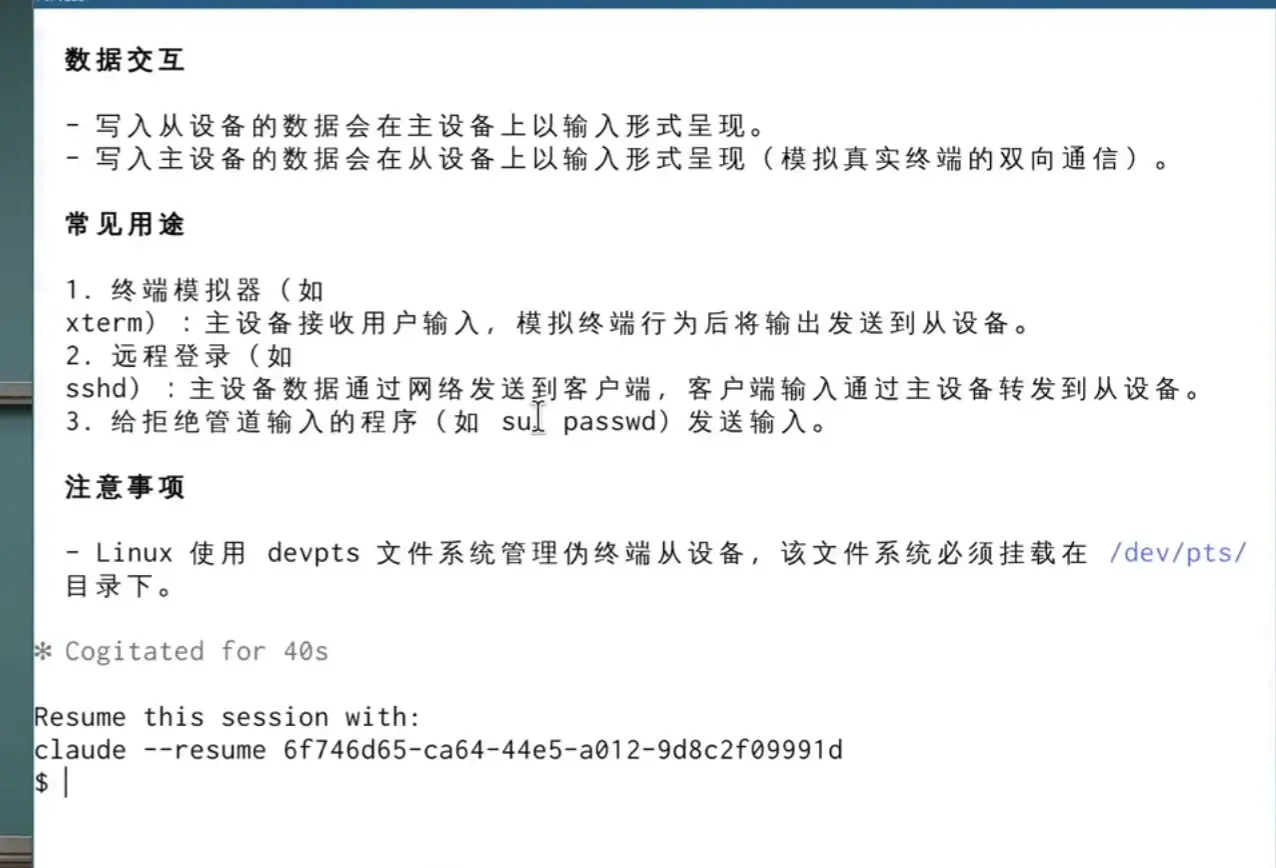
C语言可以直接调用汇编 实现了直接调用系统调用
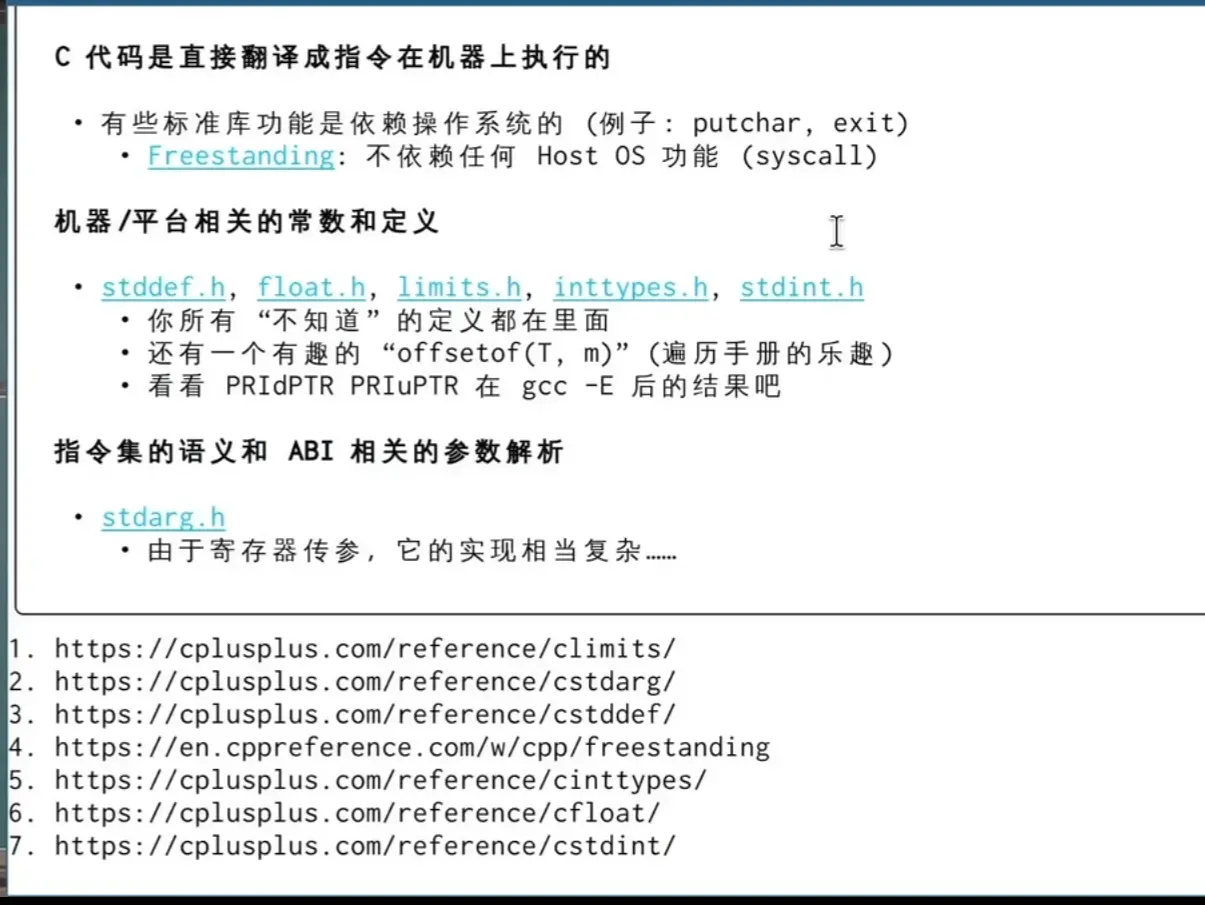
Hosted 与 Freestanding
1. 两种 C 程序运行环境
C 标准把程序运行环境大体分成两类:
Hosted Environment 托管环境Freestanding Environment 独立环境 / 裸机环境它们最核心的区别不是“有没有 libc”,而是:
程序能不能假设自己运行在一个已经准备好的完整软件环境中。
Hosted
典型例子:
Linux 用户程序Windows 用户程序macOS 用户程序程序下面已经存在:
应用程序 ↓libc / runtime ↓操作系统 ↓硬件程序员通常不用操心:
- 栈怎么建立
main谁调用printf怎么输出malloc怎么获得内存- 程序结束后谁回收资源
.bss谁清零- 文件系统、进程、终端怎么实现
这些基础设施已经由 OS、loader、C runtime 和 libc 提供。
Freestanding
典型例子:
操作系统内核BootloaderMCU 裸机程序固件 Firmware这里不能假设存在完整 OS。
结构更接近:
自己的程序 ↓自己提供的 runtime / libc 子集 / 驱动 ↓硬件也就是说:
许多在 Hosted 环境中“天然存在”的东西,在 Freestanding 环境中都需要自己提供。
2. C 语言本身和 libc 不是一回事
这是理解 Freestanding 最重要的一点。
例如:
int add(int a, int b) { return a + b;}这里的:
函数整数加法return都是 C 语言本身的能力。
它们最终可以直接变成:
movaddretCPU 能直接执行。
所以完全不需要 Linux,也不需要 libc。
但:
printf("hello");不同。
printf:
不是 C 语言语法,而是 C 标准库提供的函数。
类似的还有:
printfmallocfreefopenstrlenmemcpy因此必须区分:
C language≠libc3. 为什么 printf 特别依赖运行环境
普通 Linux 程序:
printf("hello");大致经历:
printf ↓libc ↓write 等系统调用 ↓Linux kernel ↓终端驱动 ↓设备如果你正在写 Linux 内核类似的东西:
你的 kernel ↓???下面已经没有操作系统给你调用。
因此 Freestanding 环境不能默认存在:
printf()如果想输出,就要自己构建:
自己的 printf ↓console_putc ↓UART / framebuffer / VGA ↓硬件所以:
Freestanding 并不是“绝对不能有 printf”,而是系统不会自动替你提供它。
4. memcpy 为什么比较特殊
像:
memcpy()memset()memcmp()strlen()这类函数主要只需要:
读内存写内存循环比较不依赖文件系统、进程或终端。
因此它们很适合在 Freestanding 环境中自己实现。
例如最简单的 memcpy:
void *memcpy(void *dst, const void *src, unsigned long n) { unsigned char *d = dst; const unsigned char *s = src;
while (n--) *d++ = *s++;
return dst;}本质只有:
loadstoreloop5. 一个重要陷阱:源代码没写 memcpy,编译器也可能调用它
例如:
struct Big { char data[1000];};
void f(struct Big *a, struct Big *b) { *a = *b;}编译器可能生成:
call memcpy也就是说:
编译器可能主动把某些操作转换成对 runtime helper 的调用。
于是你的 Freestanding 程序可能必须自己提供:
memcpymemmovememsetmemcmp否则链接阶段可能报:
undefined reference to `memcpy`因此:
-ffreestanding不代表编译器从此绝不会产生任何库函数依赖。
6. Hosted 程序并不是从 main 真正开始
平时:
int main() { return 0;}很容易让人产生:
程序入口 = main的错觉。
实际上 Linux 用户程序通常更接近:
Linux kernel ↓加载 ELF ↓跳到 ELF entry point ↓_start ↓C runtime 初始化 ↓main() ↓exit() ↓系统调用 ↓Linux kernel因此:
main通常是 C runtime 调用的,而不是 CPU 或 Linux 直接寻找的。
7. Freestanding 环境甚至不要求有 main
例如内核可以写:
void kernel_main(void) {}启动代码:
_start: mov rsp, stack_top call kernel_main此时执行路径:
Bootloader ↓_start ↓kernel_mainCPU 根本不知道:
mainkernel_mainruntime_init这些名字有什么特殊意义。
CPU 最终只知道地址:
0x1000000x100100...8. 那 _start 又是谁调用的?
这里要继续向下追。
例如:
CPU reset ↓BIOS / UEFI / 固件 ↓Bootloader ↓加载 kernel.elf ↓读取 ELF entry point ↓跳到 _start链接脚本中可能写:
ENTRY(_start)链接器于是会把:
_start 的地址写入 ELF 的入口信息。
Bootloader 加载后直接跳过去。
所以不存在:
CPU 看见一个叫
_start的函数,然后认为它应该执行。
真正重要的是:
入口地址9. Freestanding 程序怎么找到自己实现的 runtime
假设:
_start: call runtime_init call kernel_main而:
void runtime_init(void) {}位于另外一个源文件。
编译后:
boot.o 需要 runtime_init
runtime.o 提供 runtime_init链接器执行:
符号解析 Symbol Resolution+重定位 Relocation把:
call runtime_init最终转换成:
call 某个确定地址因此:
程序运行时并不会“寻找 runtime”。
runtime 在运行之前已经被 linker 绑定好了。
10. 两种 runtime 调用来源
需要区分两种情况。
情况一:程序员显式调用
例如:
call runtime_init过程:
程序员写调用↓产生 runtime_init 符号引用↓linker 找到自己的实现↓绑定地址情况二:编译器自动生成调用
比如源代码没写:
memcpy(...)但编译器生成:
call memcpy然后:
目标文件需要 memcpy↓linker 查找 memcpy↓找到自己实现的 memcpy↓绑定如果没有找到:
链接失败11. C Runtime 是什么
Runtime 并不是 CPU 执行 C 所必须存在的一个神秘程序。
它本质是一系列:
为了让更完整的 C/C++ 程序能够正常运行而提供的基础设施。
例如一个 Freestanding 系统可能需要:
_start ↓建立栈 ↓复制 .data ↓清零 .bss ↓初始化 CPU / 页表等 ↓初始化 console ↓初始化 allocator ↓kernel_main这些工作可以统称为:
startup/runtime initialization但如果程序特别简单:
_start: mov rsp, stack_top call kernel_main也可以根本不存在一个单独的:
runtime_init()函数。
12. 为什么 Freestanding 中需要自己初始化栈
普通 Linux 用户进程启动时:
rsp已经由系统准备好。
但裸机程序没有人替你做。
而:
call function会使用栈保存:
返回地址push、局部变量、函数栈帧也都需要:
rsp因此早期启动代码常见:
_start: mov rsp, stack_top call kernel_main如果 rsp 没有指向合法栈:
callpush都可能直接把数据写到未知地址。
所以:
建立栈往往是进入 C 世界前最基本的工作之一。
13. 为什么 .bss 也可能要自己清零
例如:
int global;C 语义要求:
global 初始值 = 0这样的未初始化全局变量通常位于:
.bssHosted 环境中,loader/runtime 会保证它为 0。
Freestanding 环境中可能需要启动代码自己:
__bss_start ↓逐字节/逐字清零 ↓__bss_end于是:
int global;这种看起来理所当然的:
初值为 0实际上也依赖程序启动阶段做过工作。
14. malloc 为什么不能凭空存在
Hosted:
malloc(100);下面大致:
malloc allocator ↓已有 heap ↓必要时 mmap / brk ↓Linux kernel但内核自己就是内存管理者。
因此 Freestanding 系统如果需要:
malloc必须先实现自己的:
物理内存分配虚拟内存管理heap allocator内核中常见:
kmallockfree而不是直接依赖用户态 libc 的 malloc/free。
15. free() 也不是机器指令
CPU 没有:
free raxfree() 本质是内存分配器的一段软件逻辑:
根据 ptr 找到内存块↓标记为空闲↓加入 free list 等数据结构↓可能复用↓不一定马上归还物理内存因此:
malloc/free属于 runtime / allocator 世界,而不是 CPU 指令集本身。
16. GCC 的 -ffreestanding
例如:
gcc -ffreestanding -c kernel.c意思是告诉 GCC:
当前程序不是普通 Hosted C 程序,不要假设完整标准运行环境存在。
典型效果包括减少编译器对于标准库环境的假设。
还可以通过:
__STDC_HOSTED__判断当前编译环境。
通常:
Hosted:
__STDC_HOSTED__ == 1Freestanding:
__STDC_HOSTED__ == 017. -ffreestanding、-nostdlib、-nostartfiles
这三个一定不要混。
-ffreestanding
主要影响:
编译阶段告诉编译器:
不要假设完整 Hosted 环境。
-nostartfiles
主要影响:
链接阶段告诉 GCC:
不要自动链接标准启动文件。
例如常见的:
crt*.o-nostdlib
范围更大:
不自动链接标准启动文件和通常的系统标准库。
所以可以粗略记为:
-ffreestanding → 编译环境假设
-nostartfiles → 不要默认启动代码
-nostdlib → 不要默认标准运行库18. libc 和 libgcc 不一样
另外一个常见混淆:
libc例如:
glibcmuslnewlib主要提供:
printfmallocstrlenfopen...而:
libgcc属于 GCC 自己的编译器 runtime 支持。
编译器在某些机器操作不能方便地直接实现时,可能生成:
runtime helper由 libgcc 提供。
所以:
libc ≠ libgccFreestanding 项目中经常需要分别考虑:
我是否需要 libc?我是否需要 compiler runtime?19. Hosted 与 Freestanding 的完整对比
| 内容 | Hosted | Freestanding |
|---|---|---|
| 操作系统 | 通常存在 | 不保证 |
| 完整 libc | 通常存在 | 不保证 |
main |
通常由 runtime 调用 | 不要求存在 |
| 程序入口 | 通常 _start 等 |
自己决定 |
| 栈初始化 | 系统/runtime 帮忙 | 往往自己处理 |
.bss 初始化 |
系统/runtime 处理 | 可能自己处理 |
printf |
一般可用 | 需要自己提供底层输出 |
malloc |
一般可用 | 需要自己的内存管理 |
fopen |
有文件系统支持 | 除非自己实现文件系统 |
memcpy |
libc 通常提供 | 常需要自己实现 |
| Runtime | 系统提供 | 自己提供或不需要 |
| 典型程序 | Linux 应用 | Kernel / MCU / Bootloader |
20. 最重要的几个结论
① C 语言和 libc 是两层东西
C language ↓可以直接编译为机器代码
libc ↓提供大量额外的软件功能② Freestanding 不等于“完全不能有 libc”
准确说法是:
不保证存在完整 libc。
你可以:
自己实现 libc 子集使用面向裸机的 libc只实现 memcpy/memset 等必要部分③ main 没有硬件层面的特殊身份
Hosted 中:
_start↓runtime↓mainFreestanding 可以:
_start↓kernel_main④ CPU 根本不知道函数名
CPU 最终看到的是:
机器地址例如:
call 0x102000而不是:
“调用 runtime_init”符号名称主要属于:
编译器汇编器链接器调试器的世界。
⑤ Freestanding runtime 不会被“自动发现”
如果想执行:
runtime_init();必须有人调用它:
_start↓call runtime_init或者编译器产生某个固定符号依赖,例如:
memcpy再由 linker 将它与自己的实现绑定。
⑥ Linker 是理解 Freestanding 的关键
过程:
source code ↓compiler ↓.o ↓symbol table + relocation ↓linker ↓ELF / binary ↓loader / bootloader ↓entry point ↓CPU execution例如:
boot.o需要 runtime_init
runtime.o提供 runtime_init
↓ linker
call runtime_init ↓
call 某个确定机器地址21. 一张图记住整个区别
Hosted────────────────────────
C Program │ ▼ libc / C runtime │ ▼ Operating System │ ▼ Hardware
Freestanding────────────────────────
C Program │ ▼ 自己的 runtime / libc 子集 │ ▼ Kernel / Firmware / 裸机代码 │ ▼ Hardware可以用一句话记:
Hosted:舞台已经搭好了,你只需要写
main。Freestanding:CPU 给你了,舞台、入口、栈、runtime、驱动乃至内存管理都可能要自己搭。
再从操作系统角度进一步压缩:
普通应用程序是在“使用操作系统”。
Freestanding kernel 则是在“成为操作系统”。这也是为什么学习操作系统以后,_start、rsp、ELF、linker、.bss、memcpy、allocator 这些原本分散的知识会突然全部串起来。
offsetof 与结构体成员偏移
1. 核心概念
对于结构体:
struct foo { int x; int y;};假设:
sizeof(int) = 4典型内存布局:
struct foo 基地址 ↓
offset 0 ┌─────────────┐ │ x │ 4 bytesoffset 4 ├─────────────┤ │ y │ 4 bytesoffset 8 └─────────────┘因此:
x 的偏移量 = 0y 的偏移量 = 4所谓成员偏移量 offset:
结构体成员地址相对于结构体起始地址的字节距离。
即:
成员偏移量=成员地址 - 结构体基地址2. p->y 的底层本质
假设:
struct foo *p;那么:
p->y从机器角度,本质就是:
结构体基地址 + y 的偏移量这里:
offset(y) = 4因此:
p->y≈读取地址 p + 4 中的 int例如:
p = 1000那么:
x 地址 = 1000 + 0 = 1000y 地址 = 1000 + 4 = 1004汇编可能类似:
mov eax, DWORD PTR [rdi+4]其中:
rdi = p所以:
[rdi+4]就是访问 p->y。
3. 结构体成员访问本质上是“基地址 + 偏移量”
可以把:
struct foo { int x; int y;};理解为编译器提前记录:
struct foo:
x → offset 0y → offset 4于是:
p->x底层相当于:
memory[p + 0]而:
p->y相当于:
memory[p + 4]注意这里说的是字节地址偏移,不是 C 中直接写 p + 4。
因为 C 的:
p + 4如果 p 是 struct foo *,实际上会移动:
4 × sizeof(struct foo)更严谨的表达是:
*(int *)((char *)p + 4)4. offsetof
C 标准库提供:
#include <stddef.h>其中:
offsetof(type, member)可以得到结构体成员相对于结构体起点的偏移量。
例如:
offsetof(struct foo, x)通常为:
0而:
offsetof(struct foo, y)通常为:
45. 经典的 offsetof 思想
经典教材中经常用下面的表达式解释原理:
&(((struct foo *)0)->y)逐层理解。
第一步
(struct foo *)0相当于:
假设一个
struct foo从地址 0 开始。
于是:
struct 基地址 = 0第二步
((struct foo *)0)->y表示找到这个假想结构体中的 y。
因为:
y offset = 4所以 y 的假想地址:
0 + 4 = 4第三步
&(((struct foo *)0)->y)取 y 的地址。
得到概念上的:
4由于结构体基地址人为设为了 0:
成员地址=0 + offset=offset所以成员地址本身就等于成员偏移量。
核心技巧:
令结构体基地址 = 0
成员地址= 基地址 + offset= 0 + offset= offset6. 实际代码不要自己这样写
虽然:
&(((struct foo *)0)->y)非常适合解释 offsetof 的原理,但实际代码应直接使用:
offsetof(struct foo, y)现代编译器通常会通过类似:
__builtin_offsetof实现它。
原因是手动构造:
(struct foo *)0涉及空指针相关语义,不适合作为可移植的正式实现。
所以:
理解原理:&(((TYPE *)0)->member)
实际使用:offsetof(TYPE, member)7. 偏移量不能简单靠 sizeof 累加
例如:
struct A { char a; int b;};不能简单认为:
a 占 1 byte所以 b offset = 1实际常见布局:
offset 0 aoffset 1 paddingoffset 2 paddingoffset 3 paddingoffset 4 b因此:
offsetof(struct A, b) = 4这是因为存在:
padding即对齐填充。
所以:
成员偏移量由编译器按照 ABI、类型大小和对齐规则决定,不能简单把前面成员的
sizeof全部相加。
8. 与汇编中的地址计算统一起来
之前见过:
mov eax, DWORD PTR [rbp-4]其本质:
基地址 rbp+偏移 -4访问某个局部变量。
结构体:
mov eax, DWORD PTR [rdi+4]本质:
基地址 rdi+成员偏移 +4访问 p->y。
二者其实是完全相同的地址计算思想:
有效地址 = 基地址 + 偏移量因此可以统一理解:
局部变量:rbp + offset
结构体成员:struct 地址 + offset
数组元素:数组首地址 + 下标 × 元素大小底层最终都归结为:
计算地址,然后访问该地址中的内存。
9. 最重要的结论
记住这几条即可:
1. offset = 成员地址 - 结构体起始地址
2. p->member 本质是: 基地址 + member offset
3. offsetof(type, member) 用来获取成员的字节偏移量
4. 经典技巧: 把 struct 基地址假设成 0, 那么成员地址就直接等于成员 offset
5. 结构体可能存在 padding, 所以 offset 不能简单靠 sizeof 手算
6. 汇编中的 [base + offset] 就是结构体成员访问最直接的底层形式一句话总结:
结构体并没有什么特殊魔法:它本质上就是一块连续内存,而字段名只是编译器帮我们记住的固定字节偏移量。
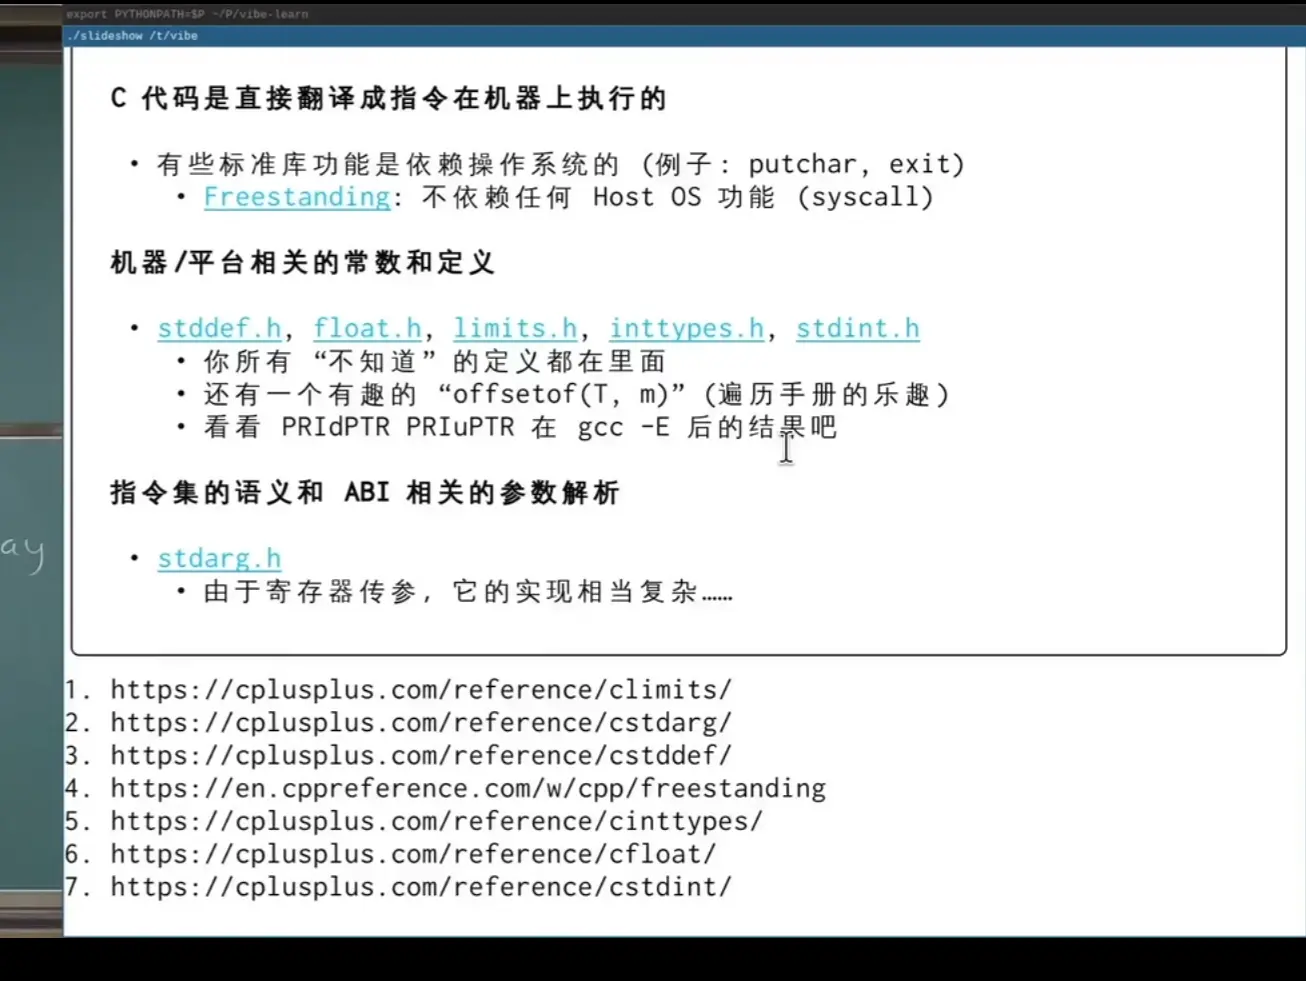
setjmp / longjmp:保存与恢复执行现场
setjmp / longjmp 是理解 执行上下文、协程、用户态上下文切换 的一个很好例子。
核心思想:
setjmp保存当前执行现场,longjmp恢复之前保存的执行现场。
1. 基本用法
#include <setjmp.h>
jmp_buf buf;
int x = setjmp(buf);
...
longjmp(buf, 5);其中:
buf可以理解为:
一个“执行现场存档”。
它不是整个栈的副本,而是保存以后恢复现场所需的关键状态。
概念上类似:
jmp_buf buf
┌──────────────────────┐│ saved rsp │ 栈顶位置│ saved rip / pc │ 恢复后从哪里继续│ saved rbp ││ 其他需要保存的寄存器 │└──────────────────────┘具体保存哪些寄存器由平台和 libc 实现决定。
2. setjmp 的作用:保存现场
假设:
int main() { int x = setjmp(buf);}执行到 setjmp(buf) 时,栈可能是:
栈顶 ↓
┌──────────────┐│ main │└──────────────┘setjmp 会把当前执行状态保存进:
buf可以粗略理解为:
buf.saved_rsp = 当前 rspbuf.saved_pc = setjmp 返回后继续执行的位置buf.saved_registers = 当前必要寄存器但:
setjmp不会主动改变当前栈。
执行前:
main执行后仍然:
main只是多了一份:
buf = 当前现场的存档3. setjmp 第一次返回 0
例如:
int x = setjmp(buf);第一次正常执行时:
setjmp(buf) ↓返回 0所以:
x = 0因此常见写法:
if (setjmp(buf) == 0) { // 第一次正常执行} else { // 从 longjmp 跳回来}4. longjmp 的作用:恢复现场
假设程序继续调用:
main ↓A ↓B此时栈:
栈顶 ↓
┌──────────────┐│ B │├──────────────┤│ A │├──────────────┤│ main │└──────────────┘但是 buf 是在只有 main 时保存的。
现在 B 中:
longjmp(buf, 5);其核心行为可以理解成:
读取 buf↓恢复当初保存的 rsp↓恢复相关寄存器↓恢复执行位置于是栈直接恢复成:
┌──────────────┐│ main │└──────────────┘A 和 B 的栈帧被直接抛弃。
5. 与普通 return 的区别
原来:
BAmain普通返回:
B return↓A
A return↓main必须逐层退出:
B → A → main而:
longjmp(buf, 5);可以直接:
B ─────────────→ main中间的:
AB栈帧一次性被丢弃。
因此称为:
non-local jump,非局部跳转
6. buf 的核心作用
buf 回答的是:
longjmp 到底应该跳回哪里?
例如:
jmp_buf a;jmp_buf b;可以分别保存两个位置:
a → main 中的某个现场
b → f() 中的某个现场那么:
longjmp(a, 1);恢复 a 保存的现场。
longjmp(b, 1);恢复 b 保存的现场。
所以:
setjmp(buf)=把当前位置写进 buflongjmp(buf, ...)=读取 buf 并恢复那个位置7. 为什么 longjmp 还有一个返回值参数
例如:
int x = setjmp(buf);第一次:
x = 0后来某处:
longjmp(buf, 5);恢复现场后,程序会表现得像:
之前那个 setjmp(buf)又返回了一次但这次:
返回值 = 5所以:
x = 5整个过程:
第一次:
setjmp(buf)↓0↓x = 0
后来:
longjmp(buf, 5)↓恢复现场↓原 setjmp 表现得像返回 5↓x = 5注意:
setjmp并没有真的重新执行一遍。
是 longjmp 恢复了现场,并安排了新的返回值。
8. longjmp 自己不会正常返回
例如:
void B() { longjmp(buf, 5);
printf("hello");}printf 不会执行。
因为:
longjmp↓B 的栈帧直接被丢弃↓跳回 setjmp 保存的位置所以真正得到 5 的不是 longjmp。
而是:
原来的
setjmp表现得像返回了5。
9. 为什么 longjmp(buf, 0) 会变成 1
规定:
setjmp 第一次正常返回 = 0如果:
longjmp(buf, 0);恢复以后也返回 0,就无法区分:
这是第一次执行?还是 longjmp 回来的?因此 C 标准规定:
longjmp(buf, 0)会使 setjmp 表现得像返回:
1总结:
| 情况 | setjmp 表现出的返回值 |
|---|---|
| 第一次正常执行 | 0 |
longjmp(buf, 5) |
5 |
longjmp(buf, 10) |
10 |
longjmp(buf, 0) |
1 |
10. 用栈理解 setjmp / longjmp
假设:
int main() { int x = setjmp(buf);
if (x == 0) A();}
void A() { B();}
void B() { longjmp(buf, 5);}执行过程:
① main
┌────────┐│ main │└────────┘执行:
setjmp(buf);保存:
buf → “当前栈只有 main”然后:
② main → A
┌────────┐│ A │├────────┤│ main │└────────┘然后:
③ main → A → B
┌────────┐│ B │├────────┤│ A │├────────┤│ main │└────────┘B 执行:
longjmp(buf, 5);直接恢复:
④
┌────────┐│ main │└────────┘同时:
setjmp 的返回值变成 511. 和 rsp / rip 的关系
真实机器上,函数执行现场至少与这些状态有关:
RSP → 栈顶在哪里RIP → 代码执行到哪里其他寄存器 → 当前计算状态所以可以粗略理解:
setjmp≈保存 rsp + 执行位置 + 必要寄存器而:
longjmp≈恢复 rsp + 执行位置 + 必要寄存器例如原来:
setjmp 时:
RSP = 1000后来调用 A、B:
RSP = 800执行 longjmp 后:
RSP = 1000于是:
A/B 的栈帧全部被放弃12. 和协程的关系
协程最核心的问题也是:
怎样暂停当前执行流,以后从原位置继续?
协程切换可以抽象成:
协程 A → 协程 B
1. 保存 A context2. 恢复 B context而:
setjmp≈ save_contextlongjmp≈ restore_context因此 setjmp/longjmp 展示了协程的核心思想:
执行现场可以保存↓以后可以恢复↓恢复后从之前的位置继续不过:
标准
setjmp/longjmp本身并不等于完整的协程实现。
真正的 stackful coroutine 通常还需要:
每个协程自己的栈+上下文保存/恢复机制+scheduler13. 一个重要限制
longjmp 只能恢复仍然有效的 setjmp 环境。
错误例子:
jmp_buf buf;
void f() { setjmp(buf);}
int main() { f(); // f 已经 return longjmp(buf, 1); // 错误}因为:
f 的栈帧已经被正常销毁此时再恢复过去保存的现场属于未定义行为。
所以:
jmp_buf不是“永久存档”。
它保存的执行环境必须仍然有效。
14. 与 OS 上下文切换的联系
setjmp/longjmp 和操作系统上下文切换有相似的核心思想:
保存执行上下文+恢复执行上下文setjmp/longjmp:
用户态程序自己保存/恢复部分执行现场OS context switch:
内核保存当前线程 CPU context↓恢复另一个线程 CPU context两者共同的底层思想:
一个执行流的身份,不只是“它执行哪个程序”,而是由栈、程序计数器和寄存器状态共同决定的。
最终记忆版
setjmp(buf)=存档
保存:栈在哪里代码执行到哪里必要寄存器状态
第一次返回 0longjmp(buf, x)=读档
恢复:栈执行位置相关寄存器
并让原 setjmp 表现得像返回 x最核心的一句话:
setjmp保存执行上下文,longjmp恢复执行上下文;普通return是逐层退栈,而longjmp可以一次跨过多个函数栈帧。
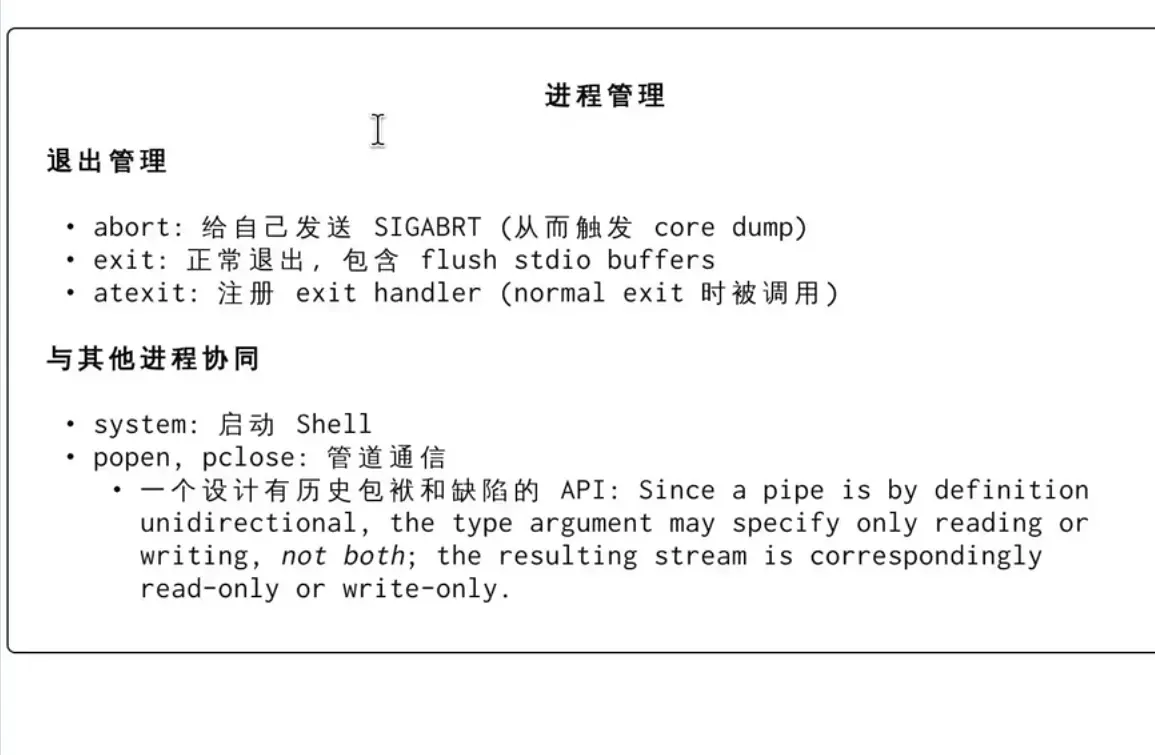
这页其实在讲两件事,而且老师把它们放在了一张 PPT 上,所以第一次看会很跳:
FILE *到底是什么,它和 Linux 的文件描述符fd有什么关系?- 为什么
printf / fprintf / vfprintf这些函数长得这么像,却不应该把代码重复写很多遍?
我们从最底层重新搭起来。
一、先别看 FILE *,先看 Linux 最底层怎么表示“打开的文件”
假设你在 Linux 里:
int fd = open("a.txt", O_RDONLY);open() 成功后可能返回:
fd = 3这个:
3就叫:
文件描述符 file descriptor
它就是一个小整数。
你可以粗略理解成内核给这个进程的一张号码牌:
进程:
fd 0 → 标准输入fd 1 → 标准输出fd 2 → 标准错误
fd 3 → a.txtfd 4 → b.txt...例如:
read(3, buf, 100);就是:
从编号为 3 的那个已打开文件读取最多 100 字节。
所以系统调用这一层是:
openreadwritecloselseek它们和:
int fd打交道。
二、那为什么 C 又搞出来一个 FILE *?
平时我们可能不写:
int fd = open(...);read(...);write(...);而写:
FILE *fp = fopen("a.txt", "r");
fscanf(fp, "%d", &x);fgets(buf, 100, fp);
fclose(fp);这里出现了:
FILE *fp这是什么?
最重要的理解是:
FILE *不是文件描述符本身。
FILE *指向 libc 在用户态维护的一个“文件流对象”。
可以想象 libc 内部有一个结构体,大概:
struct FILE { int fd;
char buffer[...];
int buffer_pos; int buffer_size;
int eof; int error;
// 还有很多状态};这只是帮助理解,真实 glibc 的 FILE 结构复杂得多。
那么:
FILE *fp;其实是:
fp │ │ 指针 ▼
┌─────────────────────┐│ fd = 3 ││ ││ buffer = ... ││ ││ 当前读到哪里 ││ 是否遇到 EOF ││ 是否发生错误 ││ ... │└─────────────────────┘所以你 PPT 第一行:
FILE *背后其实是一个文件描述符
这个说法适合入门,但稍微不严谨。
更准确应该是:
在 Unix 上,一个普通文件对应的
FILE流通常内部封装了一个文件描述符,并额外维护缓冲区、EOF、错误状态等 libc 信息。
三、那为什么不用 fd 就好了?
因为 FILE * 给我们提供了更舒服的高级功能。
例如最典型的:
直接用 write
write(fd, "hello", 5);这是比较底层的。
你得明确告诉它:
地址在哪里写多少字节而 fprintf:
fprintf(fp, "x = %d, y = %.2f\n", x, y);libc 会帮你:
整数 x ↓转换成字符
浮点 y ↓转换成字符
拼接格式字符串 ↓先塞进缓冲区 ↓必要的时候 write()这明显舒服多了。
所以:
fd=内核层面的“打开文件句柄”而:
FILE *=libc 层面的高级文件流四、最重要的一张分层图
假设:
printf("hello %d\n", 123);大致可以理解成:
你的 C 程序
printf("hello %d\n", 123) │ ▼
=========================libc / stdio=========================
FILE *stdout
格式化:"hello 123\n"
缓冲:┌──────────────────┐│ hello 123\n ... │└──────────────────┘
│ │ 最终需要真正输出 ▼
write(1, buffer, n)
=========================Linux kernel=========================
fd = 1 │ ▼
终端 / 管道 / 文件等这就是:
stdio↓系统调用↓kernel之间的关系。
五、stdout 到底是什么?
PPT 特别写了:
例如
stdout
你平时:
printf("hello\n");没有告诉 printf 输出到哪个文件。
为什么它知道输出到屏幕?
因为:
printf(...)默认向:
stdout输出。
而 stdout 本质上就是一个:
FILE *可以粗略想成:
FILE *stdout;它内部通常对应:
fd = 1也就是标准输出。
所以可以画:
stdout │ ▼FILE 对象┌─────────────────┐│ fd = 1 ││ buffer = ... ││ flags = ... ││ ... │└─────────────────┘ │ ▼Linux fd 1 │ ▼终端因此:
fprintf(stdout, "hello\n");和:
printf("hello\n");效果基本一样。
这句话非常重要:
printf(...)可以理解成“向stdout做格式化输出”。
六、那 stdin、stdout、stderr 呢?
三个都是标准 I/O 流:
stdin → 标准输入stdout → 标准输出stderr → 标准错误从 C 的角度,它们都是:
FILE *Unix 下通常对应:
stdin → fd 0stdout → fd 1stderr → fd 2所以:
C stdio Unix fd
stdin ───────────────→ 0stdout ───────────────→ 1stderr ───────────────→ 2七、FILE * 最大的一个功能:缓冲
这个非常重要。
假设你连续:
printf("a");printf("b");printf("c");你可能以为:
printf("a") → write syscallprintf("b") → write syscallprintf("c") → write syscall不一定。
因为系统调用有开销。
libc 可以先存在用户态缓冲区:
第一次 printf:
buffer:[a]第二次:
buffer:[a][b]第三次:
buffer:[a][b][c]达到某些条件之后:
一次 write:
"abc" ↓kernel这样比频繁系统调用高效。
所以 FILE 对象里一个非常重要的东西就是:
buffer 缓冲区
这也是为什么:
printf("hello");有时不会马上显示。
而:
printf("hello\n");在终端上往往更容易马上看到,因为 stdout 连到终端时通常使用行缓冲。
八、PPT 上的 fseek / fgetpos / ftell / feof 是什么意思?
它写:
封装了文件描述符上的系统调用
这里思想对,但措辞别理解得太死。
这些:
fseek()fgetpos()ftell()feof()本身都是:
libc 的 stdio 函数
不是 Linux 系统调用。
例如:
fseek(fp, 100, SEEK_SET);表示:
把
FILE *fp的文件位置移动到指定位置。
libc 可能最终调用 Linux:
lseek(fd, ...)但因为 FILE 自己还有缓冲区,所以实际逻辑可能比简单调用一次 lseek 更复杂。
可以理解:
C:
fseek(fp, ...) │ ▼libc stdio │ │ 必要时 ▼lseek(fd, ...) │ ▼kernel九、feof() 更能说明 FILE * 不只是 fd
比如:
if (feof(fp)) { ...}它是在问:
这个 stdio 流是不是已经遇到 EOF?
这个 EOF 状态很多时候是:
libc 的 FILE 对象自己记录的例如:
FILE┌────────────────────┐│ fd = 3 ││ buffer = ... ││ eof_flag = 1 ││ error_flag = 0 │└────────────────────┘所以:
feof(fp)可能主要是在检查:
fp->eof_flag并不意味着每执行一次 feof() 都去做一次系统调用。
这就是为什么更准确地说:
FILE *是建立在 Unix 文件描述符之上的一层 libc 抽象。
十、现在看 PPT 下半部分:printf() family
下面突然写:
The
printf()family
为什么突然从 FILE * 跳到 printf?
因为 printf 系列大量使用:
FILE *例如:
printf(...)fprintf(...)vprintf(...)vfprintf(...)其中最关键的就是 PPT 最下面:
int vfprintf(FILE *, const char *, va_list);完整声明类似:
int vfprintf( FILE *stream, const char *format, va_list ap);先不怕 va_list。
我们一项一项看。
十一、fprintf 比 printf 多了什么?
printf:
printf("x = %d\n", x);固定输出到:
stdout而:
fprintf(fp, "x = %d\n", x);可以指定:
输出到 fp所以可以把:
printf(...)理解成:
fprintf(stdout, ...)概念上非常接近:
printf(format, ...){ fprintf(stdout, format, ...);}当然实际实现不能如此简单地直接传 ...,马上解释。
十二、... 为什么是个麻烦?
例如:
printf("%d %s %f", 10, "hello", 3.14);参数数量是不固定的:
format10"hello"3.14另一个:
printf("%d", 10);只有两个参数。
这种:
...叫:
可变参数 variadic arguments
例如函数声明:
int printf(const char *format, ...);十三、va_list 是什么?
为了在一个函数内部遍历:
...这些可变参数,C 提供:
va_list可以暂时理解为:
“剩余可变参数在哪里”的一个迭代器/描述对象。
例如:
va_list ap;表示:
ap ↓10"hello"3.14...然后可以通过:
va_arg(...)依次取得参数。
所以:
vfprintf(FILE *stream, const char *format, va_list ap)意思就是:
给我一个输出流、一个格式字符串,以及已经整理好的可变参数列表,我负责完成真正的格式化输出。
十四、为什么需要 vfprintf?
这就是 PPT 上:
这些代码里应该没有 “code clones”
要讲的东西。
假设 libc 要实现:
printffprintfvprintfvfprintf最蠢的方法是:
printf: 写一遍解析 %d %s %f 的代码
fprintf: 再写一遍解析 %d %s %f 的代码
vprintf: 再写一遍
vfprintf: 再写一遍这就是:
code clone
大量重复代码。
很糟糕。
十五、更漂亮的方法:只写一个核心
我们让:
vfprintf()承担真正复杂的工作:
vfprintf
解析 format↓发现 %d↓取一个 int
发现 %s↓取一个 char *
发现 %f↓取一个 double
↓格式化
↓写入指定 FILE *其他函数都包装它。
于是结构类似:
vfprintf / \ / \ printf fprintf更准确地说是其他函数最终复用核心逻辑。
十六、例如 printf 可以怎样实现?
概念版:
int printf(const char *format, ...){ va_list ap;
va_start(ap, format);
int ret = vfprintf(stdout, format, ap);
va_end(ap);
return ret;}这段特别值得看。
调用:
printf("x = %d\n", 123);进入:
printf之后:
format = "x = %d\n"
ap ↓123然后:
vfprintf(stdout, format, ap);于是:
vfprintf
输出目标:stdout格式:"x = %d\n"参数:123最终:
x = 123写入 stdout。
十七、fprintf 同样可以复用
概念上:
int fprintf(FILE *fp, const char *format, ...){ va_list ap;
va_start(ap, format);
int ret = vfprintf(fp, format, ap);
va_end(ap);
return ret;}所以区别只是:
printf ↓vfprintf(stdout, ...)而:
fprintf ↓vfprintf(fp, ...)真正复杂的:
%d%s%x%f格式宽度精度...解析,只需要写一次。
这就是 PPT:
不应该出现 code clones
的意思。
十八、现在整张 PPT 就串起来了
上半部分讲:
FILE *是 stdio 的核心抽象。
例如:
stdinstdoutstderrfopen() 得到的 fp都是文件流。
下半部分讲:
既然我们已经有统一的
FILE *抽象,那么各种格式化输出函数也可以统一实现。
核心:
vfprintf(FILE *stream, const char *format, va_list ap);其中:
FILE *stream↓往哪里输出format↓怎么格式化va_list↓要格式化的数据所以 vfprintf 几乎把三个问题完全分开了。
十九、完整调用链看一次
假设:
printf("age = %d\n", 20);可以粗略理解:
你的代码
printf("age = %d\n", 20) │ ▼
printf │ │ 把可变参数整理成 va_list ▼
vfprintf(stdout, "age = %d\n", ap) │ ▼
解析格式字符串
"age = ""%d" → 取 20"\n"
│ ▼
得到字符:
"age = 20\n"
│ ▼
写入 stdout 的 FILE buffer
│ │ 必要时 flush ▼
write(fd=1, ...) │ ▼
Linux kernel │ ▼
终端这张图就是整页 PPT 真正想表达的东西。
二十、和你之前学的 Hosted/Freestanding 正好连起来
你前面问过:
libc 到底干什么?
这里就是一个非常具体的例子。
CPU 本身没有:
printf "x=%d"这样的机器指令。
Linux kernel 也没有一个:
printf syscall真正的 Linux 系统调用更加底层:
write所以:
printf("%d", 123);中间大量工作其实发生在:
libc:
高级 C 接口
printffprintfvfprintfFILE *缓冲区格式化EOF 状态 ↓
低级 OS 接口
read/write/lseekfd ↓
kernel这就是为什么 stdio.h 是 Hosted C 世界里很重要的一层抽象。
二十一、最后压缩成四层
这页你最后只需要建立这个模型:
第一层:你的 C 代码────────────────────
printf(...)fscanf(...)fgets(...)
第二层:libc stdio────────────────────
FILE *vfprintfbufferEOF/error state
第三层:Unix 系统调用────────────────────
fd
readwritelseekclose
第四层:kernel────────────────────
文件系统终端管道设备...然后记住两个对应:
fd=内核给进程的“打开文件编号”FILE *=libc 对 fd 等底层对象做出的高级“文件流包装”以及:
printf(format, ...)≈vfprintf(stdout, format, va_list)这就是 PPT 最下面为什么突然出现:
int vfprintf(FILE *, const char *, va_list);它是 printf 家族非常核心的复用接口:把“输出到哪个流”“格式字符串是什么”“可变参数是什么”统一起来,避免每个 printf 家族函数都重新实现一遍格式化逻辑。
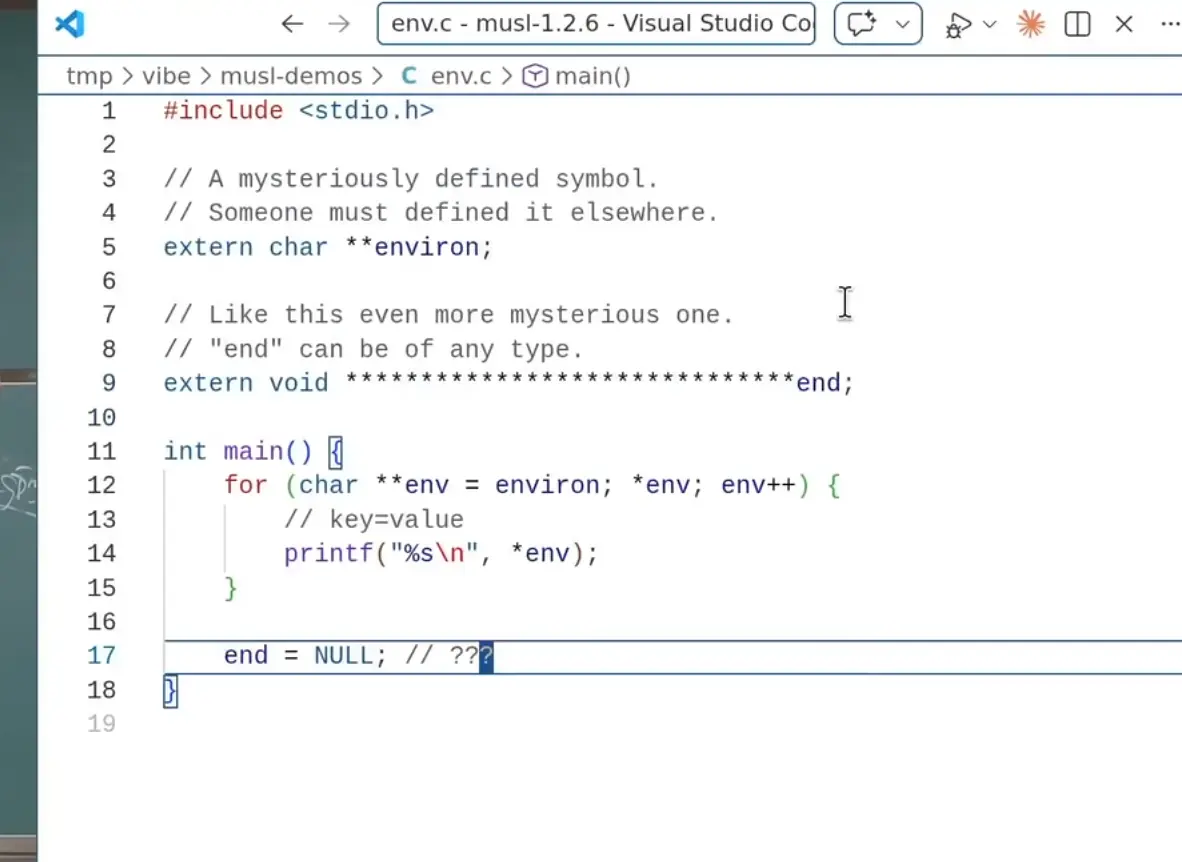
你看到老师写:
extern void **************end;然后说:
"end" can be of any type
你可能感觉:
什么?C 语言不是强类型吗?变量类型怎么可以乱写?
关键在于:
这里的 end 根本不是一个普通 C 变量。
它是一个 链接器符号(linker symbol)。
1. 先回忆普通变量是什么
比如:
int x = 100;编译器看到:
变量名:x类型:int大小:4字节于是生成:
.data
地址 0x1000:
+---------+| 100 |+---------+
x这里:
x 有:
- 名字
- 类型
- 大小
- 内存位置
所以:
x + 1编译器知道:
int 加法2. 但是 end 不一样
例如:
extern int end;这里你告诉编译器:
有一个叫 end 的东西,类型是 int,但是它定义在别处。
注意:
这里没有:
int end = 10;没有分配空间。
编译器只记录:
符号表:
end真正是谁定义它?
以后链接器负责。
3. 链接器看到 end 是什么?
比如链接器最后发现:
程序内存布局:
.text----------------机器代码
.data----------------全局变量
.bss----------------未初始化变量
heap----------------动态内存
stack----------------栈链接器知道:
.bss 结束地址 = 0x601000于是它可能产生:
符号表:
end ---> 0x601000注意:
这里:
end不是一个对象。
它只是:
一个地址标签。
类似汇编:
section .data
hello: db "hello"这里:
hello:是什么?
只是一个地址名字。
4. 所以为什么类型可以乱?
因为:
真正存在的是:
地址不是:
变量例如:
假设:
end 地址:
0x1000你写:
extern int end;编译器理解:
end 地址 = 0x1000这里放一个 int所以:
printf("%d", end);会去读:
0x1000 ~ 0x1003但是如果:
extern char end;编译器理解:
end 地址 = 0x1000这里放一个 char于是:
printf("%c", end);读:
0x1000如果:
extern void *end;编译器理解:
end 地址 = 0x1000这里存一个指针于是:
printf("%p", end);它会把:
0x1000 ~ 0x1007解释成一个地址。
但是注意:
链接器完全不关心这些。
链接器只知道:
end = 0x1000它不知道:
int?char?pointer?5. 一个汇编类比
汇编里面:
end:就是一个标签:
例如:
.text
start: mov eax, 1
end:这里:
start = 0x400000end = 0x400005汇编器不会问:
end 是 int 还是 char?
因为汇编里没有类型。
C 的:
extern int end;只是告诉 C 编译器:
用什么方式访问这个地址。
6. 那为什么老师写:
extern void **************end;?
这是为了故意说明:
类型不重要。
例如:
extern int end;和:
extern char end;和:
extern void *end;链接器都认为:
我要找一个叫 end 的符号7. 但是这样真的安全吗?
不安全。
比如:
链接器:
end = 0x1000实际:
那里没有 int。
你写:
extern int end;
printf("%d", end);相当于:
读取:
0x10000x10010x10020x1003如果这些地址不可读:
可能:
Segmentation fault所以:
可以乱写 ≠ 应该乱写。
这是因为:
链接阶段只匹配名字,不检查 C 类型。
8. 这个和 Linux 内核有什么关系?
很多底层代码会用这种技巧。
例如:
Linux 内核链接脚本:
_start = .;
.text{ ...}
_end = .;产生符号:
_start_end然后 C:
extern char _end[];得到:
内核/程序结束位置例如:
heap_start = _end;意思:
堆从程序结束后开始。
这里 _end 就不是变量。
它是:
一个地址标记9. 和你前面学的进程内存布局联系起来
程序加载后:
高地址
stack | |heap
_end ← 这里
.bss.data.text
低地址链接器知道:
.text 结束在哪里.data 结束在哪里.bss 结束在哪里所以它生成:
_end = bss结束地址程序运行时:
extern char _end;
brk(_end);就可以知道:
初始堆应该从哪里开始。
10. 最终记忆
普通变量:
int x;是:
名字+类型+大小+内存链接器符号:
end是:
名字+地址没有类型。
所以:
extern int end;extern char end;extern void *end;链接器看到:
我要找 end全部一样。
区别只是:
C 编译器以后访问这个地址时,按照你声明的类型解释它。
一句话:
end可以乱写类型,是因为它本质上不是 C 变量,而是链接器提供的一个地址符号;类型只是 C 编译器为了生成访问代码而做的假设,链接器根本不管。
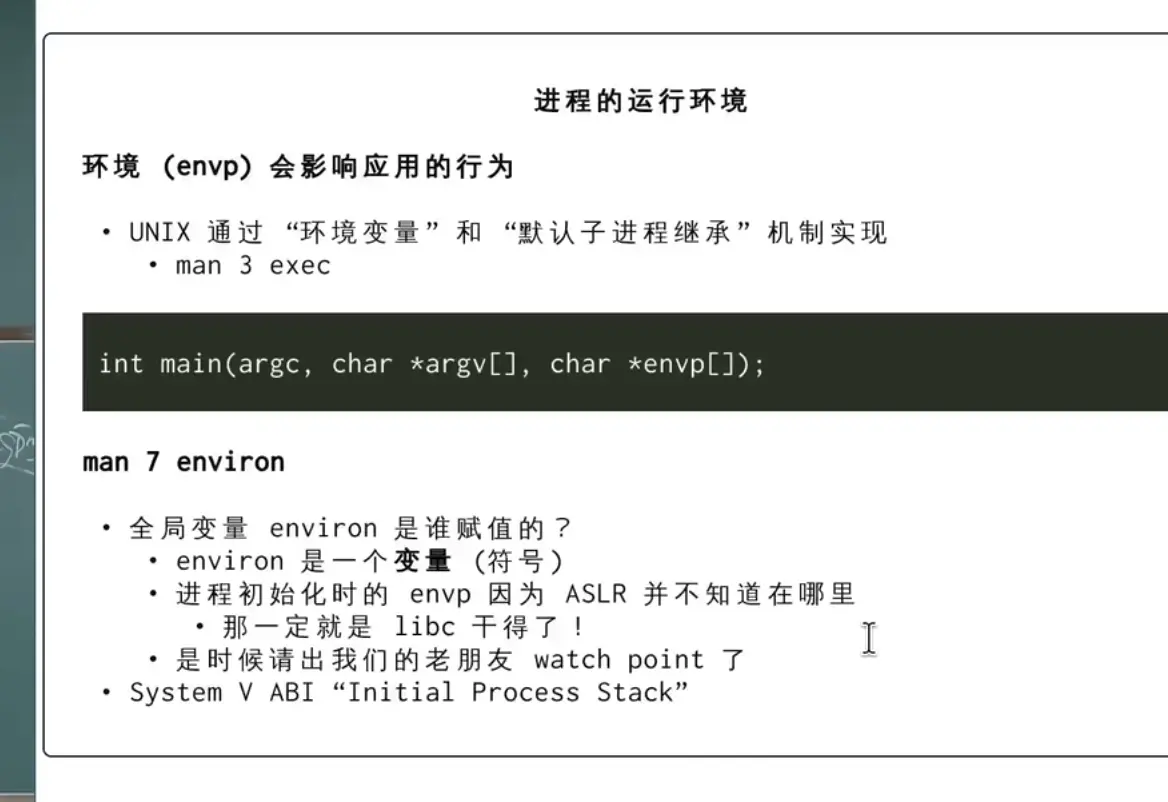
这个知识点其实和你前面学的 environ 正好形成对比:
environ:真正的变量(有类型、有内存)end:链接器符号(主要是一个地址标签)
这也是为什么老师说它“more mysterious”。它已经跨到 C 和 ELF 链接层了。
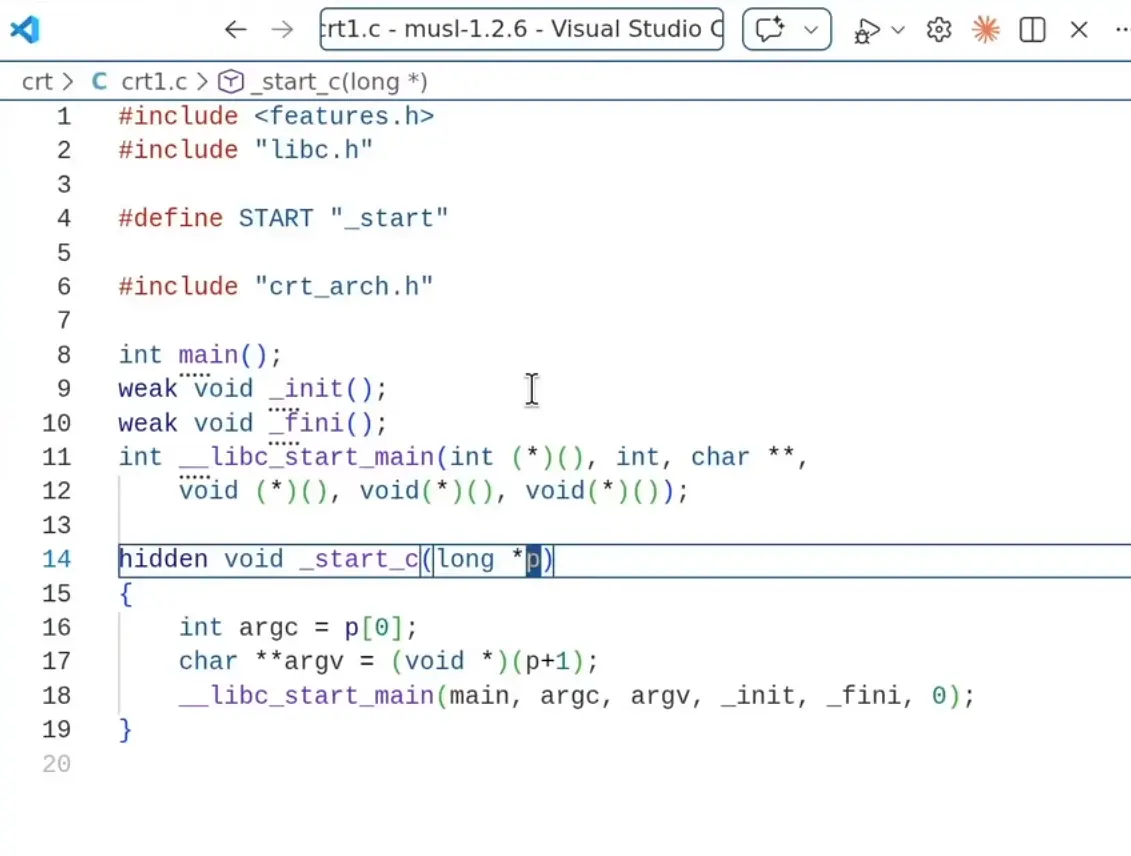 _ start会调用上述代码,由于操作系统规定了初始栈的形状 所以可以通过上面函数直接调到环境变量
_
分享文章
生成精美分享图或复制链接,与更多人分享本文。
继续阅读
换条路线
从其他文章中稳定抽取
最后更新于 ,距今已过 86 天
部分内容可能已过时